第十一章、redis集群(cluster)
1、是什么?
1、由于数据量过大,单个Master复制集难以承担,因此需要对多个复制集进行集群,形成水平扩展每个复制集只负责存储整个数据集的一部分,这就是Redis的集群,其作用是提供在多个Redis节点间共享数据的程序集。
2、看图秒懂
3、总之
- redis是一个提供在多个redis节点间共享数据的程序集
- redis集群可以支持多个master
2、能干嘛?
1、redis集群支持多个master,每个master可以挂多个slave
- 读写分离
- 支持数据的高可用
- 支持海量数据的读写操作
2、Cluster自带sentinel的故障转移机制,内置高可用的支持(自带哨兵)
3、槽位slot负责分配到各个物理服务节点,有对应的集群来负责维护结点、插槽和数据之间的关系
3、集群算法—分片—槽位slot
1、redis集群的槽位slot
1、这里redis集群引入的哈希槽的概念
2、就是说redis集群有16384个槽位,通过keyCRC16取模来计算,我这个key值要放在哪个槽位
3、可以理解为,学校里面的每个宿舍,一个宿舍住一个key,算一个槽位。学校总共有16384个宿舍,槽位
2、redis集群的分片
1、redis集群会将存储的数据分配到多台redis机器上。每个redis实例就被认为是整个数据的分片
2、如何找到给定key的分片
- 也是通过key进行CRC16(key)算法处理并通过对总分片数量取模,然后使用确定性哈希函数
3、可以理解为,数据要放到槽位里面(宿舍),然后有多台redis机器,我们把每台机器所存的槽位范围设置成分片。如,立德苑1栋分配了多少个宿舍(槽位),有几栋这样的宿舍楼,就是有几个分片
3、优势
1、方便扩所容量和数据分派查找。
2、就像二分查找法算法一样,方便
4、slot槽位映射,三种方法
1、就是如何来找到槽位和数据之间的映射,哪个数据放哪个槽位?
1、哈希取余分区
1、就是有几台服务器,就有几个分区,几个分母
2、公式:hash(key)/xx。其中xx是分区
3、缺点
- 扩容和缩容会比较麻烦
- 如果分母变了,根据计算出来的槽位所对应的数据位置就会不可控
- 会导致hash取余全部数据重新洗牌
2、一致性哈希算法分区
1、是什么?
1、为了解决这个问题:分布式缓存数据变动和映射问题,某个机器宕机了,分母数量改变了,自然取余数不OK了。
2、能干嘛?
1、提出一致性hash解决方法
2、就是为了解决哈希取余分区中,分母改变影响客户端到服务器的映射关系
3、目的:如果分母变了,也尽可能减少影响客户端到服务器的映射
3、三大步骤
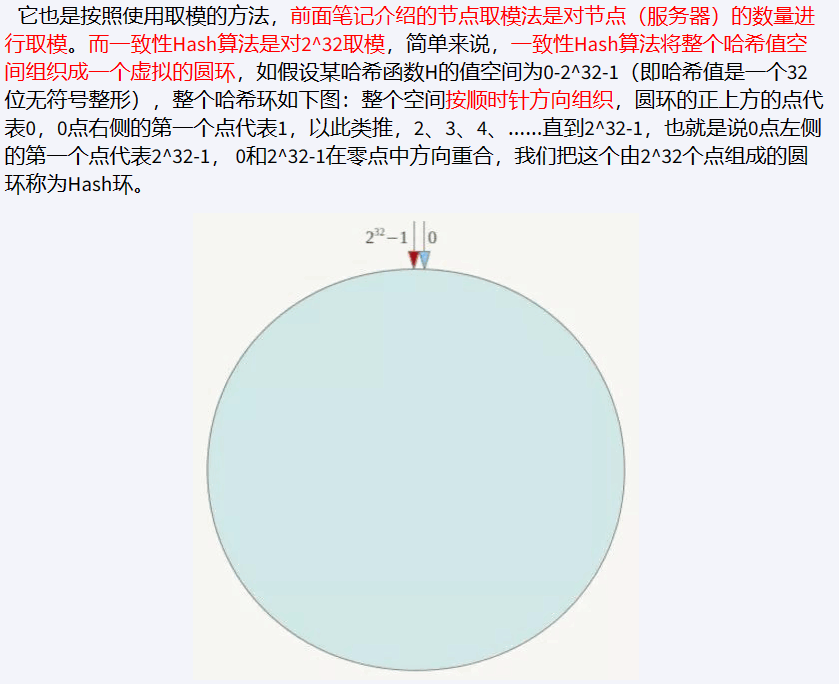
1、算法构建一致性哈希环
- 就是用哈希函数按照算法,产生哈希值。然后构成一个集合。
- 这个集合有0~2^32-1的大小
- 然后用逻辑控制,将这个集合头尾相连,成为一个环
- 如图

2、redis服务器IP节点映射
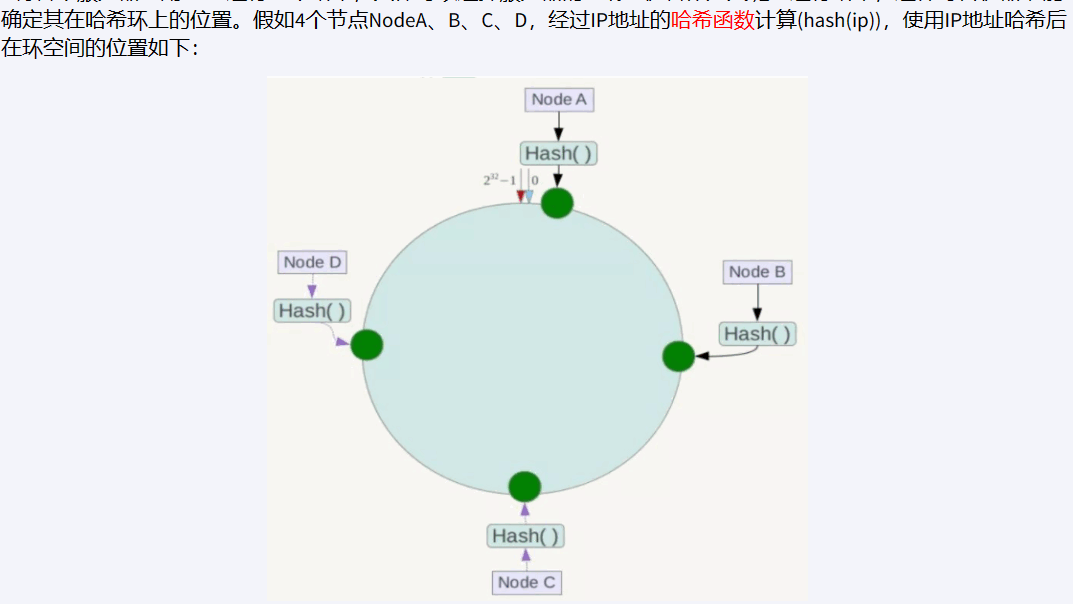
- 将各个服务器使用hash进行一个哈希,具体通过ip或则主机名作为关键字,来创建一个哈希。
- 每个机器就能在哈希环上确定一个位置。
- 如图所示
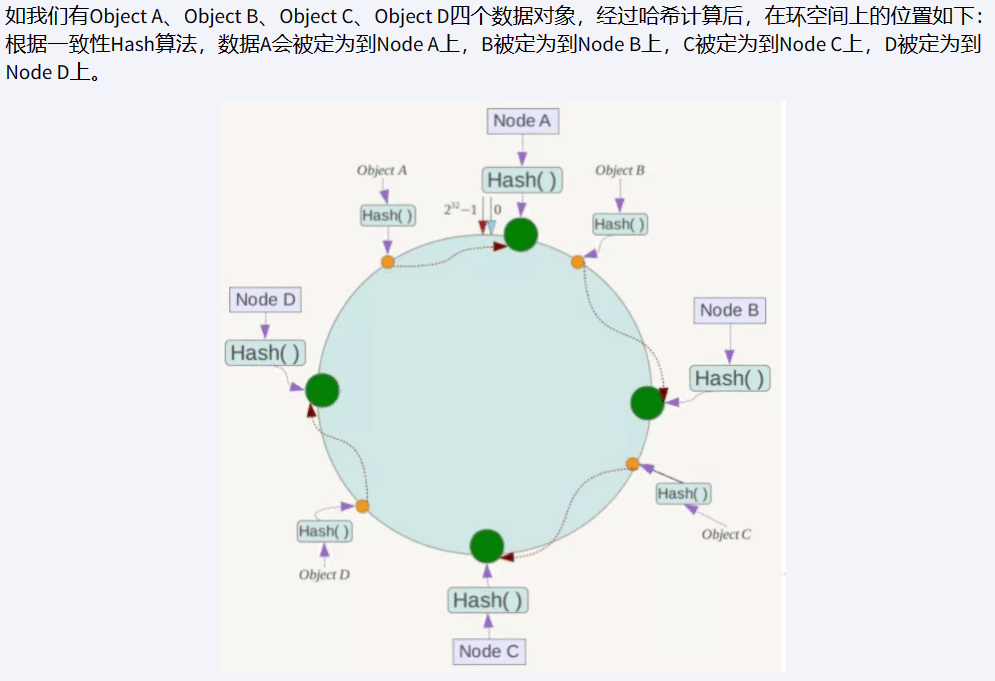
3、key落到服务器的落键规则
- 我现在要存储一个key值,我们要计算key 的哈希值。使用相同的哈希函数计算出hash值就可以确定数据在环上的位置。
- 然后沿着这个环,顺时针走遇到第一台服务器,这个key值就在这个服务器上(节点)
- 如图
4、优点
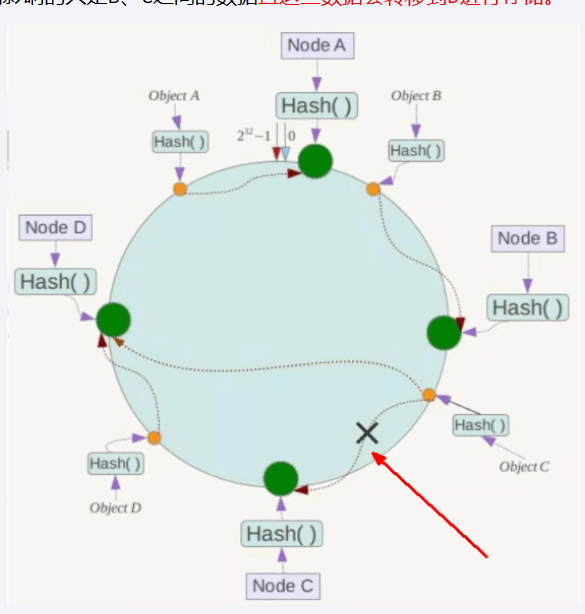
1、一致性哈希算法的容错性
- 就是如上图,NodeC挂了,ObjectC数据要顺时针走,发现C坏了,就去找Node D 数据从而能保存
- 如图
2、一致性哈希算法的扩展性
- 我要加入一台服务器还是挺简单的,我可以通过redis对服务器ip的映射,然后就可以在hash环上新增一个节点(服务器)
5、缺点
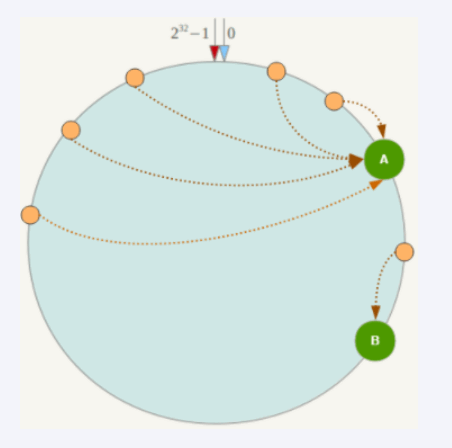
1、hash环的数据倾斜问题
- 如果只有2个节点,就会发现数据倾斜的问题严重。
- 就是一个节点卖死卖活,另一个节点非常清闲
- 如图
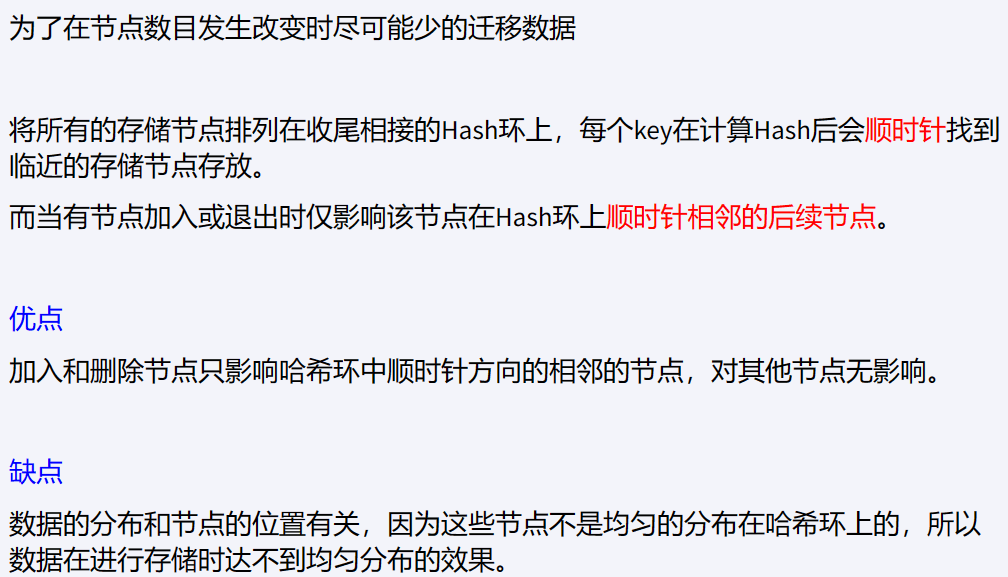
6、总结
3、哈希槽分区
1、是什么?
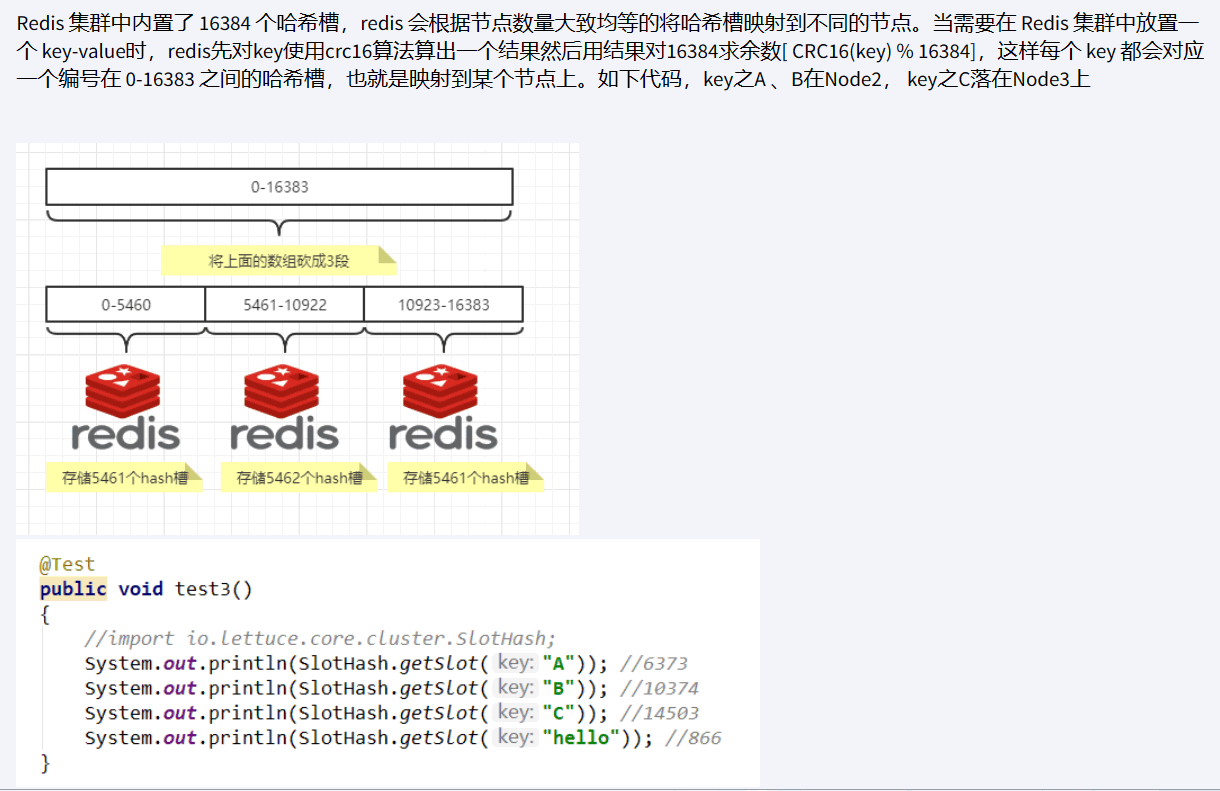
1、实质就是一个数组,数组大小为[0,2^14-1] =16384
2、能干嘛?
1、解决均匀分配的问题
2、就是在数据和服务器之间又加了一层。称为哈希槽(slot)
3、主要目的是:把粒度变大,从而达到机器整体均匀分布数据
3、要用多少个hash槽
1、一般是16384。但没强制要求
2、公式
HASH_SLOT = CRC16(key)mod 163843、通过上面公式得到,就是数据位置
4、如图(解释)
5、面试题:为什么redis最大槽是16384个
1、解释一
1、CRC16算法产生的hash是2^16
2、因为心跳包如果用2^16次方/1024 = 8KB
3、心跳包如果用2^14/1024 = 2KB
4、这样对网络传输的压力减小,每秒要发一定数量的ping心跳包,浪费带宽
2、解释二
1、redis集群主节点的数量不会太大,基本不会超过1000个
3、解释三
1、槽位越小,节点少的情况下,压缩比越高,越容易传输
4、实验案例
1、三主三从集群配置
1、配置三台虚拟机
1、各自新建
mkdir -p /myredis/cluster2、其中-p是建立多级文件夹
2、新建6个独立redis实例服务
1、IP:192.168.171.129 6381和6382
-
6381
-
bind 0.0.0.0 daemonize yes protected-mode no port 6381 logfile "/myredis/cluster/cluster6381.log" pidfile /myredis/cluster6381.pid dir /myredis/cluster dbfilename dump6381.rdb appendonly yes appendfilename "appendonly6381.aof" requirepass 111111 masterauth 111111 cluster-enabled yes cluster-config-file nodes-6381.conf cluster-node-timeout 5000 -
6382
-
bind 0.0.0.0
daemonize yes
protected-mode no
port 6382
logfile "/myredis/cluster/cluster6382.log"
pidfile /myredis/cluster6382.pid
dir /myredis/cluster
dbfilename dump6382.rdb
appendonly yes
appendfilename "appendonly6382.aof"
requirepass 111111
masterauth 111111

cluster-enabled yes
cluster-config-file nodes-6382.conf
cluster-node-timeout 5000
2、IP:192.168.171.132 6383和6384端口
-
6383
-
bind 0.0.0.0 daemonize yes protected-mode no port 6383 logfile "/myredis/cluster/cluster6383.log" pidfile /myredis/cluster6383.pid dir /myredis/cluster dbfilename dump6383.rdb appendonly yes appendfilename "appendonly6383.aof" requirepass 111111 masterauth 111111 cluster-enabled yes cluster-config-file nodes-6383.conf cluster-node-timeout 5000 -
6384
-
bind 0.0.0.0
daemonize yes
protected-mode no
port 6384
logfile "/myredis/cluster/cluster6384.log"
pidfile /myredis/cluster6384.pid
dir /myredis/cluster
dbfilename dump6384.rdb
appendonly yes
appendfilename "appendonly6384.aof"
requirepass 111111
masterauth 111111

cluster-enabled yes
cluster-config-file nodes-6384.conf
cluster-node-timeout 5000
3、IP:192.168.171.133 6385和6386端口
-
6385
-
bind 0.0.0.0 daemonize yes protected-mode no port 6385 logfile "/myredis/cluster/cluster6385.log" pidfile /myredis/cluster6385.pid dir /myredis/cluster dbfilename dump6385.rdb appendonly yes appendfilename "appendonly6385.aof" requirepass 111111 masterauth 111111 cluster-enabled yes cluster-config-file nodes-6385.conf cluster-node-timeout 5000 -
6386
-
bind 0.0.0.0
daemonize yes
protected-mode no
port 6386
logfile "/myredis/cluster/cluster6386.log"
pidfile /myredis/cluster6386.pid
dir /myredis/cluster
dbfilename dump6386.rdb
appendonly yes
appendfilename "appendonly6386.aof"
requirepass 111111
masterauth 111111

cluster-enabled yes
cluster-config-file nodes-6386.conf
cluster-node-timeout 5000
4、启动这6台redis服务器
redis-server /myredis/cluster/redisCluster638x.conf- x是端口号
5、通过redis-cli命令为6台机器构建集群关系
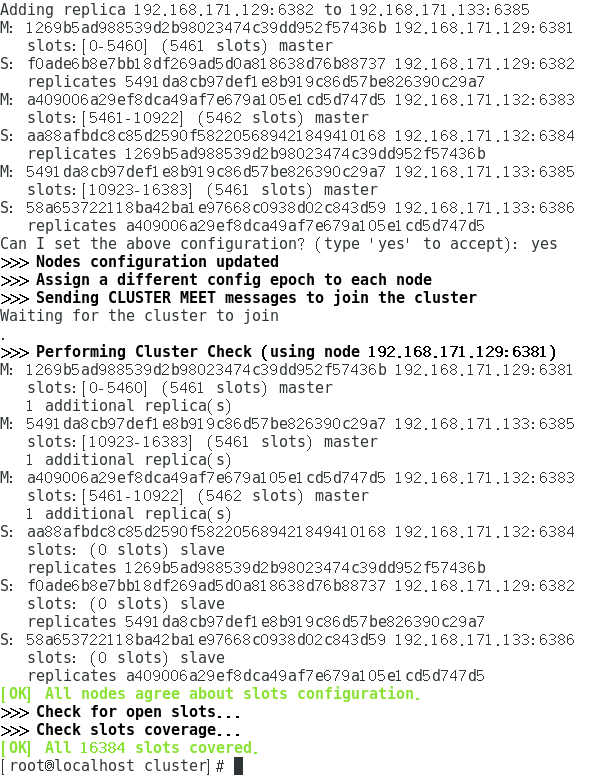
redis-cli -a 111111 --cluster create --cluster-replicas 1 192.168.171.129:6381 192.168.171.129:6382 192.168.171.132:6383 192.168.171.132:6384 192.168.171.133:6385 192.168.171.133:6386- 成功如图
6、连接诶6381作为切入点,查看集群状态
-
info replication -
cluster info -
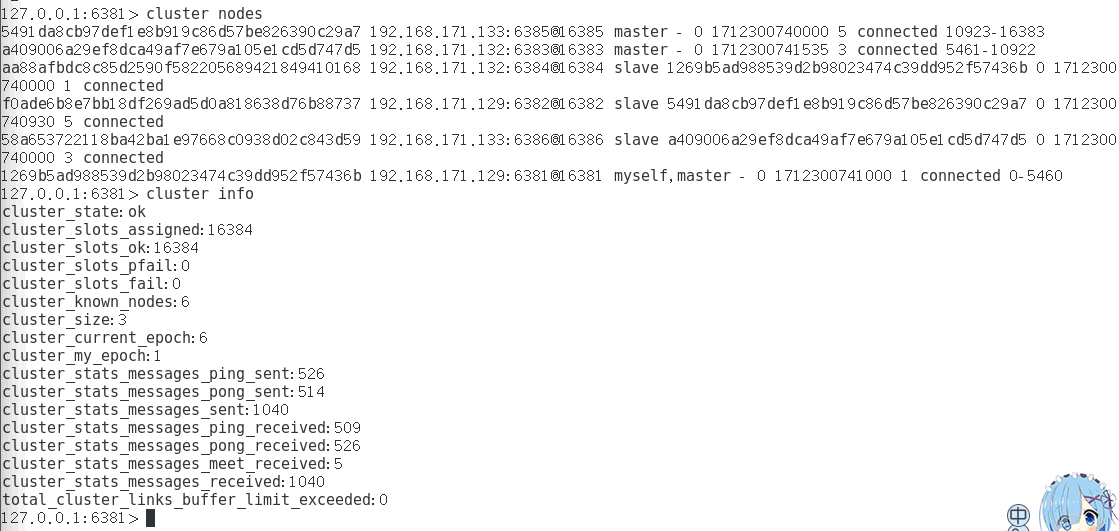
cluster nodes
3、梳理逻辑
1、master主机:6381
- slave从机:6384
2、master主机:6383
- slave从机:6386
3、master主机:6385
- slave从机:6382
4、看下图可知以上的逻辑
2、3主3从redis集群读写
1、对链接成功的6381进行新增key
1、出现问题
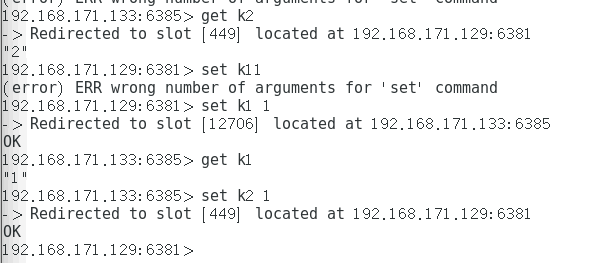
ERR wrong number of arguments for 'set' command2、如图
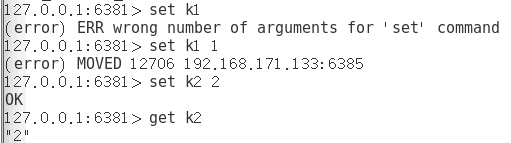
3、这个问题的出现,是因为槽位的范围有问题。要路由到位
4、就是我现在加入的key,要分给一个槽位。但是16384个槽位,要进行分区,就是宿舍和宿舍楼的关系。我刚刚加入这个k1,槽位的范围不对,就无法加入才会报错
2、解决以上问题
1、我们只要加入防止路由失效假如一个参数-c就行
2、先退出
quit3、加入-c参数
redis-cli -a 111111 -p 6381 -c4、如图
3、查看某个key对应的槽位
1、命令
cluster keyslot xxx(key)3、主从容错切换迁移案例
1、容错切换迁移
1、主6381和从机切换
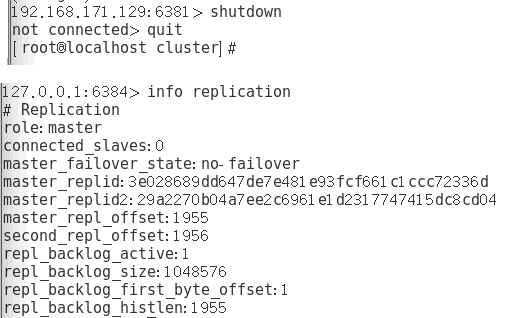
1、我们直接把6381shutdown掉
2、看看6384会不会顶替6381的master角色
- 结果
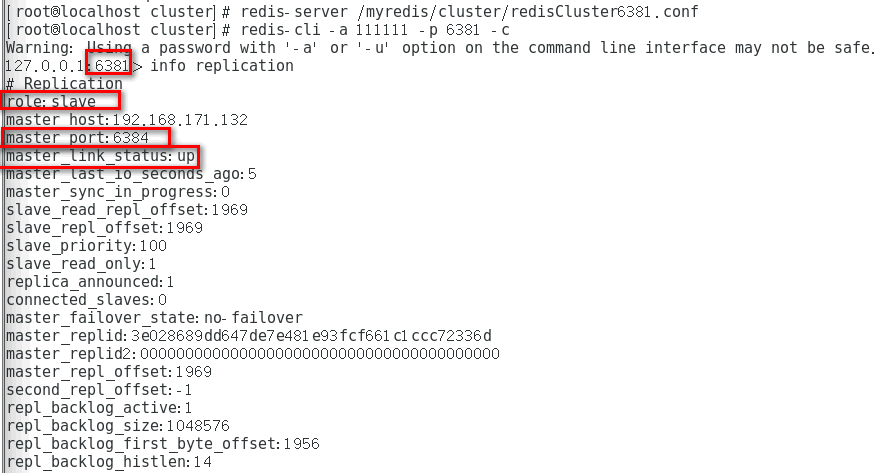
3、我们把6381从新启动,看看原来的master还能上位吗
- 答案是否定的,6381和6384的角色互换了
2、集群不包住数据一致性100%
1、就是说,再怎么样,也会有数据丢失
2、就如果6381死了,在其他slave上位期间,是不存数据的,会丢失一点点
3、手动故障转移or 角色互相调整
1、我容错迁移的时候,发现了6381和6384的角色互相调换了。
2、不符合我们的原始设计图。我们现在要换回来,怎么办
1、操作
1、我们重新登录要还原上位的那台机器
2、这里就是6381端口的主机
3、我们登入6381
-
redis-cli -a 111111 -p 6381 -c
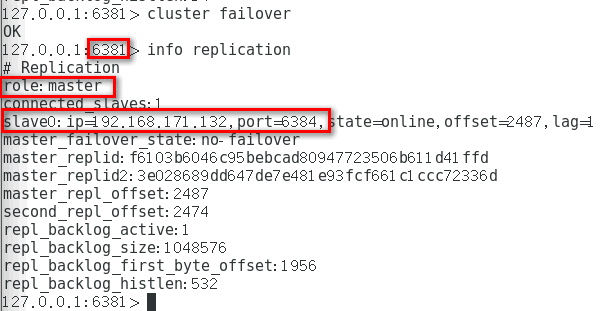
4、然后使用命令
-
cluster failover
5、结果如图
4、主从扩容案例
1、新建6387和6388两个服务器的配置文件
1、IP:192.168.171.133 6387和6388端口的服务器配置文件
-
6387
bind 0.0.0.0 daemonize yes protected-mode no port 6387 logfile "/myredis/cluster/cluster6387.log" pidfile /myredis/cluster6387.pid dir /myredis/cluster dbfilename dump6387.rdb appendonly yes appendfilename "appendonly6387.aof" requirepass 111111 masterauth 111111 cluster-enabled yes cluster-config-file nodes-6387.conf cluster-node-timeout 5000 -
6388
-
bind 0.0.0.0
daemonize yes
protected-mode no
port 6388
logfile "/myredis/cluster/cluster6388.log"
pidfile /myredis/cluster6388.pid
dir /myredis/cluster
dbfilename dump6388.rdb
appendonly yes
appendfilename "appendonly6388.aof"
requirepass 111111
masterauth 111111

cluster-enabled yes
cluster-config-file nodes-6388.conf
cluster-node-timeout 5000
2、启动87/88实例
redis-server /myredis/cluster/redisCluster6387.conf
redis-server /myredis/cluster/redisCluster6388.conf
3、将87/88节点加入原集群
1、把6387和6388作为master加入集群
2、这里要注意,我们需要一个领路人(就是原本集群中有的端口机器)来帮助我们加入集群
2、命令
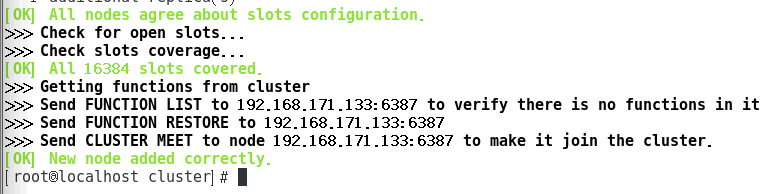
redis-cli -a 密码 --cluster add-node 自己实际IP地址:6387 自己实际IP地址:原有集群的端口号3、这里我们以6381作为领路人,将6387加入原有集群
redis-cli -a 111111 --cluster add-node 192.168.171.133:6387 192.168.171.129:6381- 如图算成功
4、检查集群的情况
-
命令
-
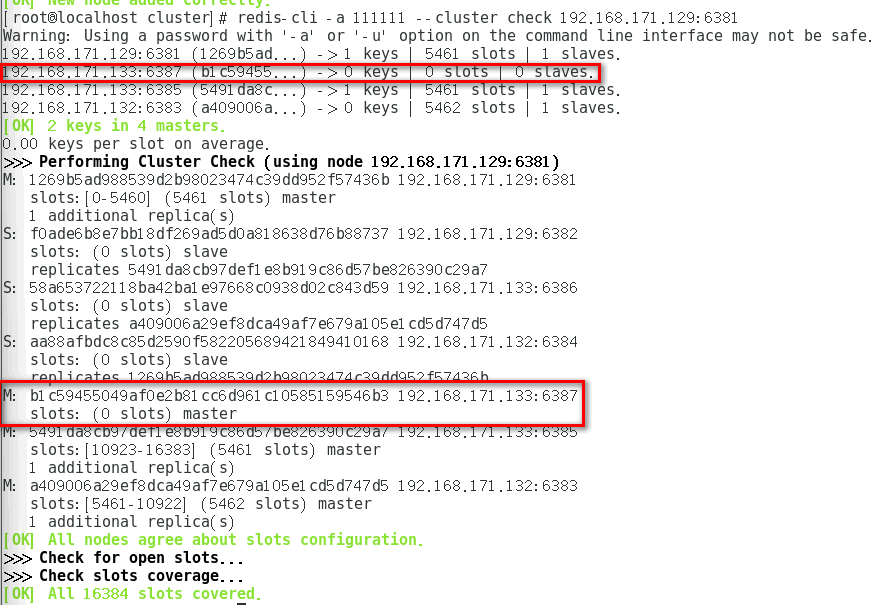
redis-cli -a 密码 --cluster check 真实ip地址:6381 -
这里以6381为例
-
redis-cli -a 111111 --cluster check 192.168.171.129:6381 -
如图算是真正加入成功
-
5、重新分配槽号(reshard)
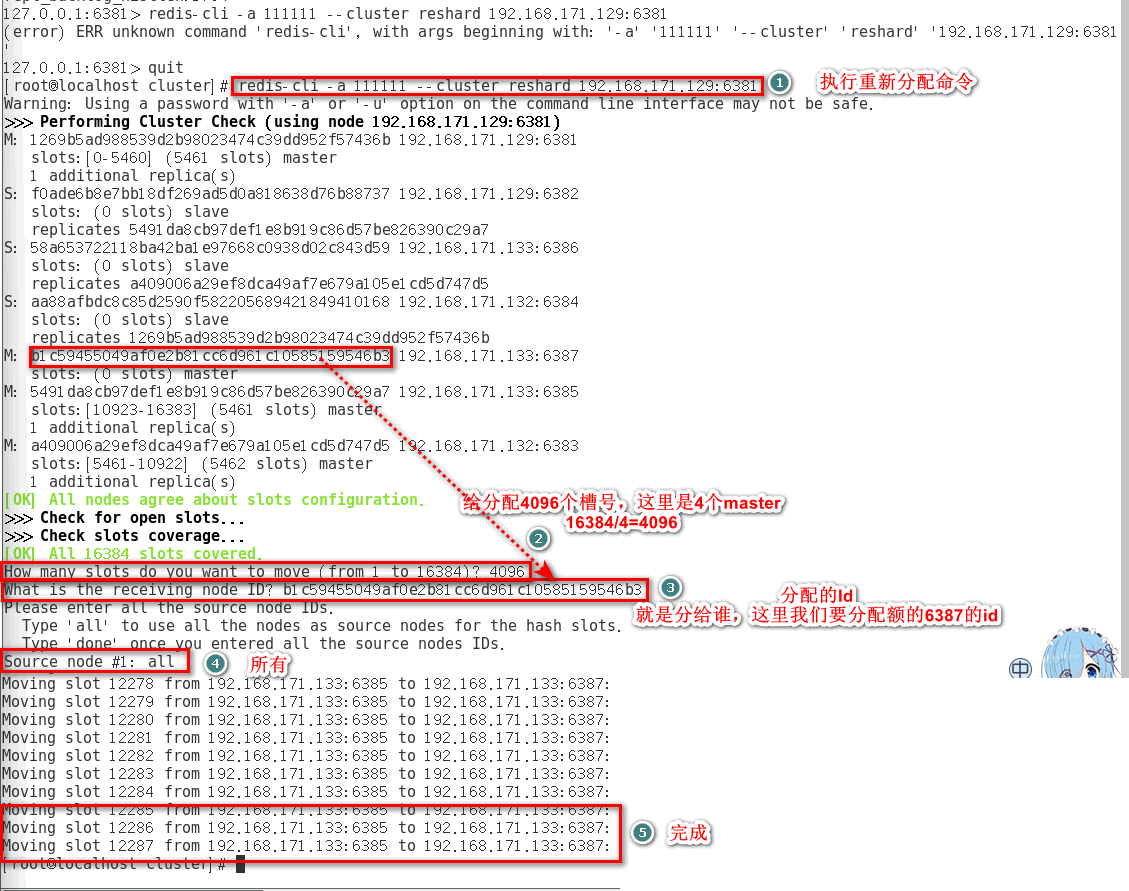
1、就是说我们现在加入的这个6387并没有分到slot槽号,就是没办法加入和查询数据。所以我们要分配槽号资源
2、命令
redis-cli -a 密码 --cluster reshard IP地址:端口号3、这里以6381进行
redis-cli -a 111111 --cluster reshard 192.168.171.129:63814、如图
6、检查集群情况
1、和第4步骤一样的命令
-
命令
-
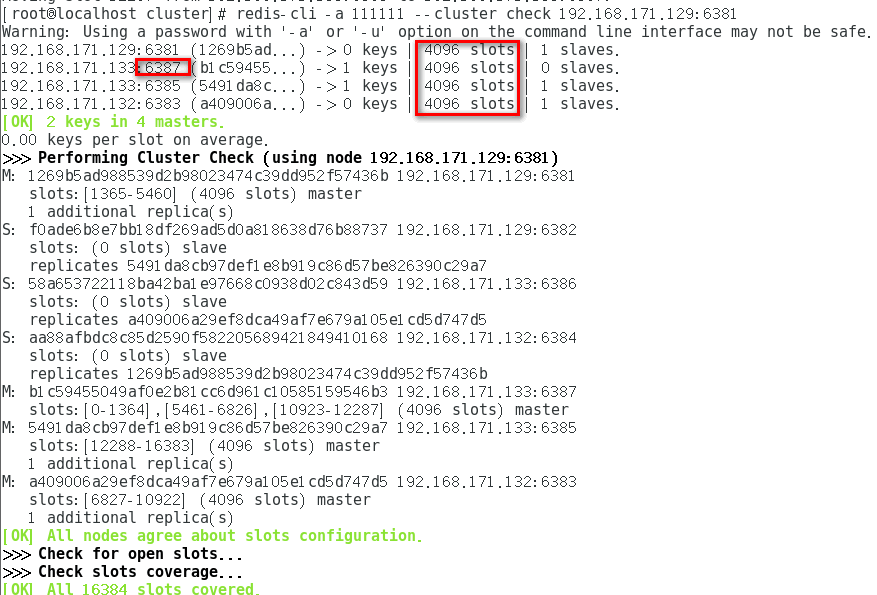
redis-cli -a 密码 --cluster check 真实ip地址:6381 -
这里以6381为例
-
redis-cli -a 111111 --cluster check 192.168.171.129:6381 -
如图算是真正加入成功
-
7、为主节点6387分配从节点6388
1、命令
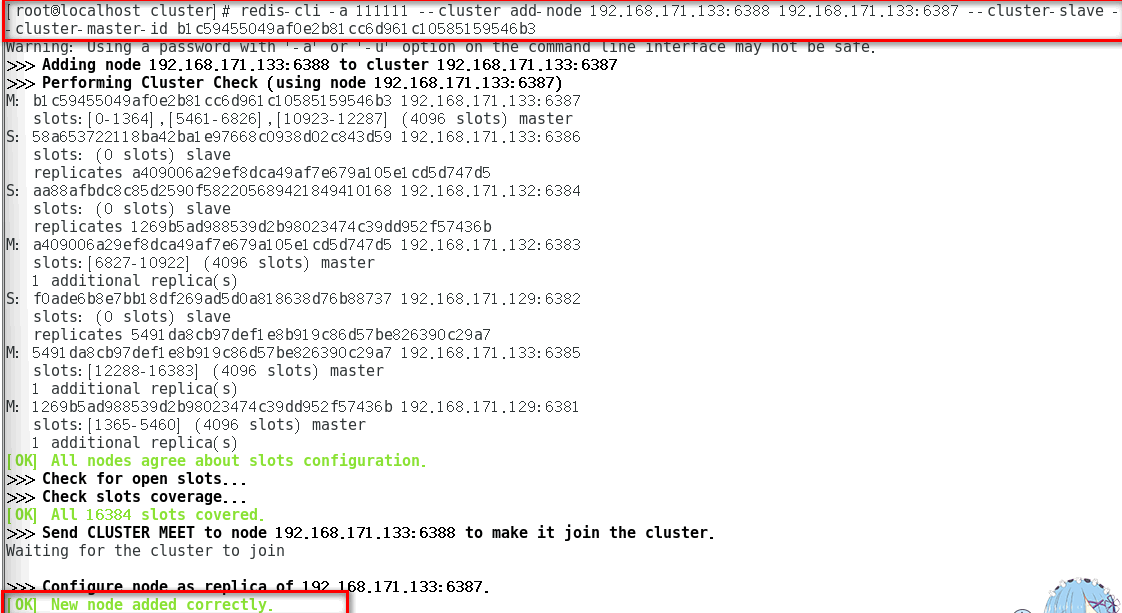
redis-cli -a 密码 --cluster add-node ip:新slave端口 ip:新master端口 --cluster-slave --cluster-master-id 新主机节点ID2、这里以6388为例
redis-cli -a 111111 --cluster add-node 192.168.171.133:6388 192.168.171.133:6387 --cluster-slave --cluster-master-id b1c59455049af0e2b81cc6d961c10585159546b33、如图
8、检查集群情况
-
命令
-
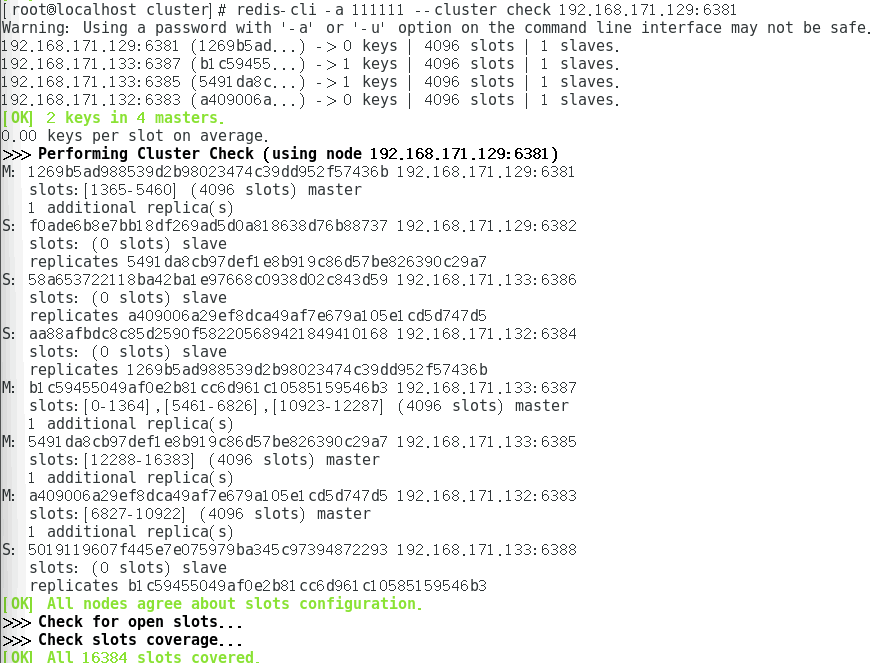
redis-cli -a 密码 --cluster check 真实ip地址:6381 -
这里以6381为例
-
redis-cli -a 111111 --cluster check 192.168.171.129:6381 -
如图算是真正加入成功
-
5、主从缩容案例
1、这里我们要将6387和6388这两个机器下线,达到缩容的效果
1、获取节点6388节点ID
1、检查集群情况
redis-cli -a 111111 --cluster check 192.168.171.133:63882、6388结点的ID
5019119607f445e7e075979ba345c973948722932、从集群中将4号从节点6388删除
1、命令
redis-cli -a 密码 --cluster del-node ip:从机端口 从机6388节点ID2、这里以6388为例
redis-cli -a 111111 --cluster del-node 192.168.171.133:6388 5019119607f445e7e075979ba345c97394872293- 如图算是成功

3、将6387分配到的槽号清空
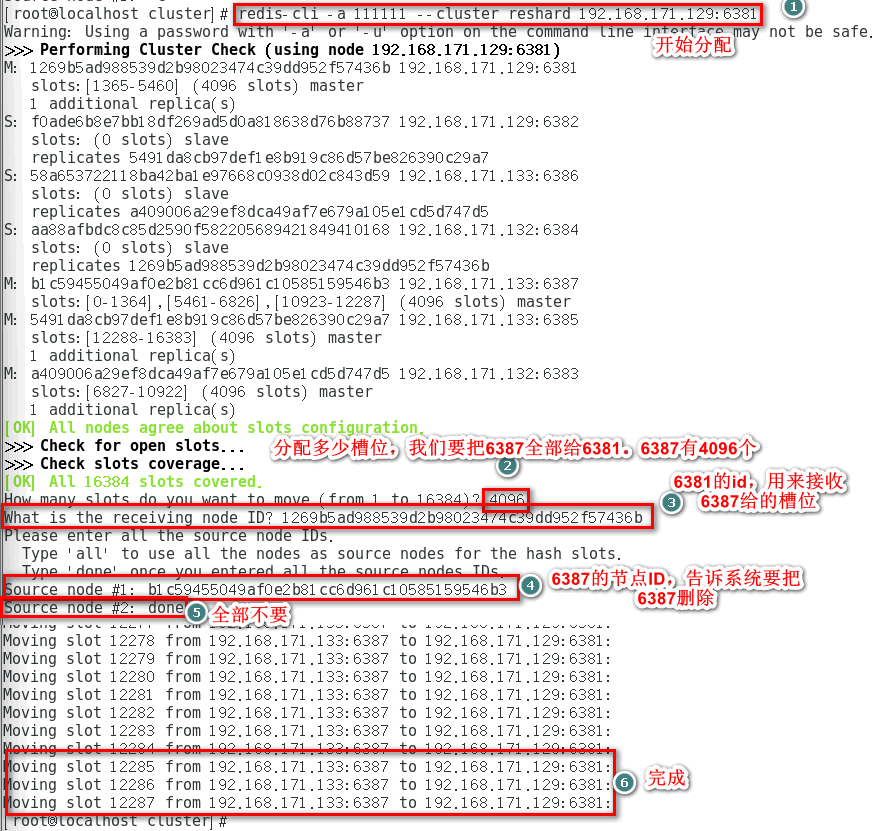
1、我们这里将6387之前分配到的槽号清空
2、然后重新分配:命令和reshare一样
3、我们这里把6387的槽号,全部给6381。也可以各个机器分一点,看个人
redis-cli -a 111111 --cluster reshard 192.168.171.129:63814、如图算是成功
4、检查集群情况
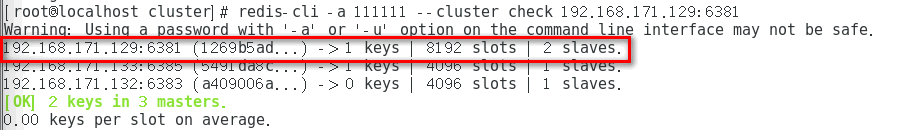
1、这里检查6381。看看有没有分到6387的槽位
redis-cli -a 111111 --cluster check 192.168.171.129:63812、如图确实分到了
5、删除6387节点
1、槽位也回归了,现在可以正式放心的删除6387了
2、命令
redis-cli -a 密码 --cluster del-node ip:端口 6387节点ID3、例子
redis-cli -a 111111 --cluster del-node 192.168.171.133:6387 b1c59455049af0e2b81cc6d961c10585159546b34、删除成功如图

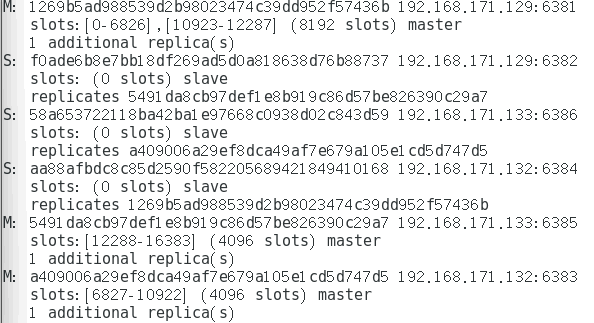
6、检查集群情况
1、这里检查6381。看看有没有分到6387的槽位
redis-cli -a 111111 --cluster check 192.168.171.129:63812、如图确实6387/6388都被删除了
5、集群常用操作命令和CRC16算法分析
1、注意
1、在不同的slot槽位下多键操作不太好,提示符占位符
2、如图下操作
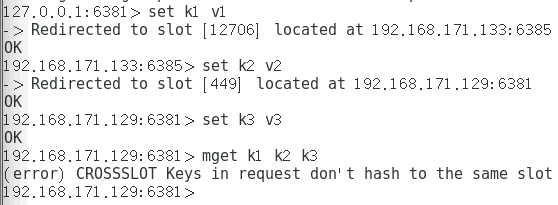
3、我们发现设置了3个key,在不同的分片里面,我们要全部获取,就发现,不同的slot槽位,值无法获取
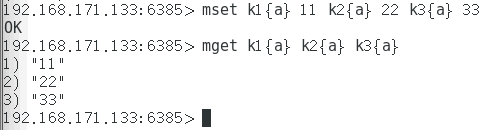
4、所以我们引用了占位符:{}
5、操作
mset k1{a} 11 k2{a} 22 k3{a} 33mget k1{a} k2{a} k3{a}6、结果如图
2、常用命令
1、集群是否要完整才能对外服务
1、现在有3个master,如果一个master挂了,每个master负责的slot就会有变化。2/3个slot。redis默认就不对外服务,因为不完整了
2、我们可以设置一个配置,强行对外服务
cluster-require-full-coverage yes #默认是no2、获取槽位数字编号
1、命令
CLUSTER COUNTKEYSINSLOT xxxx槽号2、如图
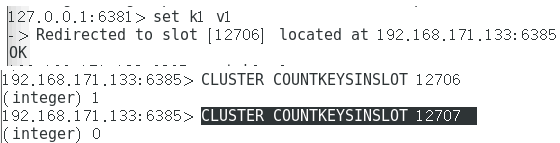
3、1表示槽号被占用了
4、0表示槽号没被占用
3、键名称指令
CLUSTER KEYSLOT key(key的名称)