五、XML
1、XML简介和作用
1.1、xml简介
1、xml是可扩张的标记性语言。
1.2、作用
1、用于保存数据,而且这些数据具有自我描述
2、它还可以作为项目或者模块的配置文件
3、还可以做为网络传输数据的格式(现在以JSON为主)
2、xml语法
2.1、文档声明
1、声明
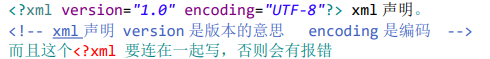
2、属性
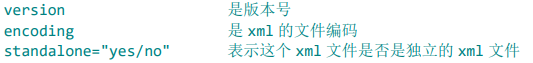
2.2、xml注释
1、和html一样
2、格式:\
2.3、元素
1、什么是xml元素内容
1、元素是指从开始标签到结束标签的内容。
2、元素 我们可以简单的理解为是 标签。 Element 翻译 元素
2、命名规则
1、名称可以含有字母、数字以及其他字符
2、名称不能以数字或标点符号开始
3、名称不能以字符“xml”或者(XML、Xml)开始(其实是可以的)
4、名称不能包含空格
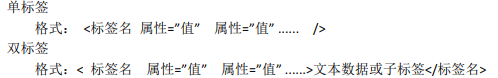
3、项目了元素也分单标签和双标签
1、单标签和双标签格式
4、xml属性
1、xml属性和html标签属性是非常类似的,属性可以提供元素的额外信息
2、标签上可以写属性:一个标签可以写多个属性,每个属性值必须用引号,引起来。
5、xml语法规则
1、所有XML元素都必须是关闭标签(闭合)
2、XML标签对大小写敏感
3、XML必须正确嵌套
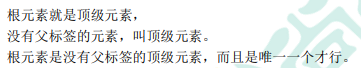
4、XML文档必须由根元素
6、xml中的特殊字符
1、>:\>
2、<:\<
7、xml文本区域(CDATA区)
1、内容:告诉xml解析器,该函数内全部都是文本
2、CDATA格式:

2.4、xml解析技术介绍
1、xml介绍
1、xm是可扩展的标记语言
2、不管html还是xml文件都是标记型文档,都可以使用w3c组织制定的dom技术来解析。
3、图解
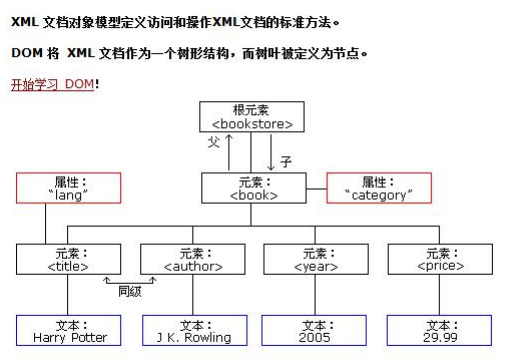
4、document对象表示的是整个文档(可以是xml,也可以是html)
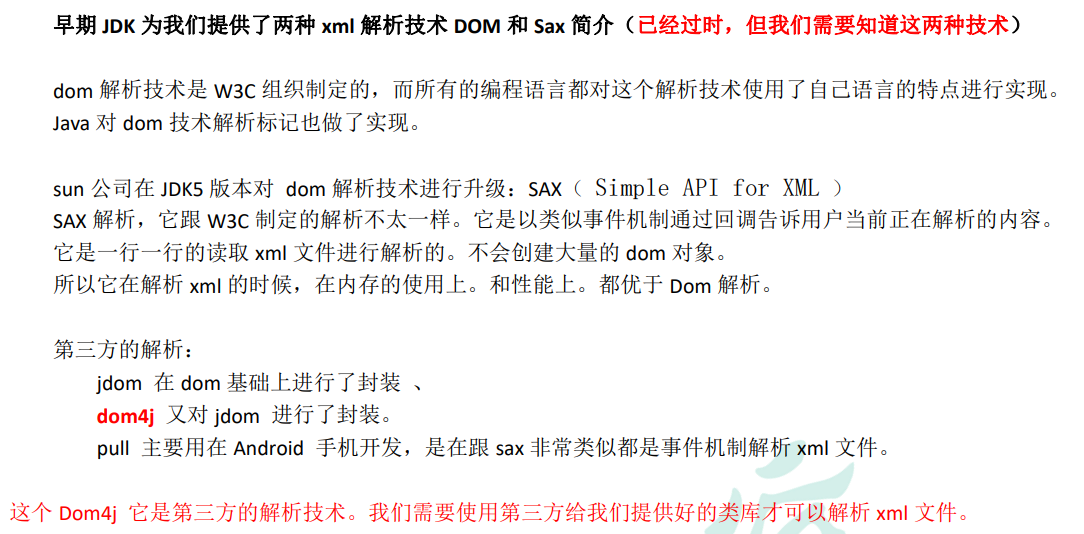
2、了解两种xml技术DOM和Sax(已过时,作为了解)
1、内容
2.5、dom4j解析技术
1、编程步骤
1、步骤
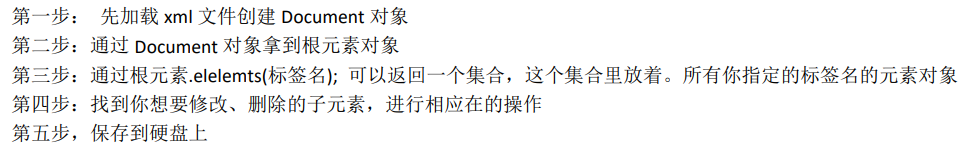
2、获取document对象
1、创建一个 lib 目录,并添加 dom4j 的 jar 包。并添加到类路径。
3、遍历标签获取所有标签内容
1、步骤
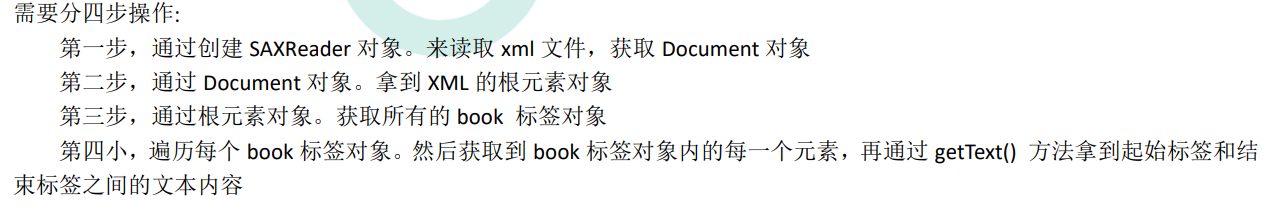
4、例子
将xml中内容转换为Book类内容
1、该xml为需要被解析的内容
<?xml version="1.0" encoding="UTF-8"?>
<books>
    <book sn="SN12341232">
        <name>辟邪剑谱</name>
        <price>9.9</price>
        <author>班主任</author>
    </book>
    <book sn="SN12341231">
        <name>葵花宝典</name>
        <price>99.99</price>
        <author>班长</author>
    </book>
</books>
2、获取document对象代码
/*
* dom4j 获取 Documet 对象
*/
@Test
public void getDocument() throws DocumentException {
// 要创建一个 Document 对象,需要我们先创建一个 SAXReader 对象
SAXReader reader = new SAXReader();
// 这个对象用于读取 xml 文件,然后返回一个 Document。
Document document = reader.read("src/books.xml");
// 打印到控制台,看看是否创建成功
System.out.println(document);
}
3、创建Book类,一些get和set方法
package src.com.qt.pojo;

import java.math.BigDecimal;
public class Book {
    private String sn;
    private String name;
    private Double price;
    private String author;

 //get和set这里省略不写
 //构造器也是,无参和有参都要
 //toString省略
4、编写遍历代码
    /*
    读取books.xml文件生成book类
     */
    @Test
    public void test2() throws DocumentException {
//        1、通过books.xml文件
        SAXReader reader = new SAXReader();
//        2、在Junit测试中,相对路径是从模块开始算
        Document document = reader.read("05_xml/src/books.xml");
//        3、通过根元素获取book标签对象
        Element rootElement = document.getRootElement();
//        element 和elements都是通过标签名查找子元素的
        List<Element> books = rootElement.elements("book");
//        4、遍历,处理每个book标签转换为Book类
        for (Element book:books){
//          asXML()把标签对象。转换为标签字符串
            Element nameElement = book.element("name");
//            getXML():把标签对象,转换为标签字符串
            String nameText = nameElement.getText();
//            直接获取指定标签名的文本内容
            String  priceText = book.elementText("price");

            String authorText = book.elementText("author");

            String snValue = book.attributeValue("sn");

            System.out.println(new Book(snValue,nameText,Double.parseDouble(priceText),authorText));
        }

    }
}