正则表达式
1、作用:处理文本
1、用途:文本查找,筛选
2、正则表达式的基本介绍
1、用某种模式去匹配字符串的一个公式。
2、正则表达式不止java有
3、正则表达式底层实现
1、理解
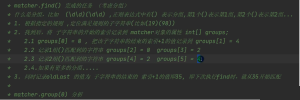
2、group源码
    public String group(int group) {
        if (first < 0)
            throw new IllegalStateException("No match found");
        if (group < 0 || group > groupCount())
            throw new IndexOutOfBoundsException("No group " + group);
        if ((groups[group*2] == -1) || (groups[group*2+1] == -1))
            return null;
        return getSubSequence(groups[group * 2], groups[group * 2 + 1]).toString();
    }
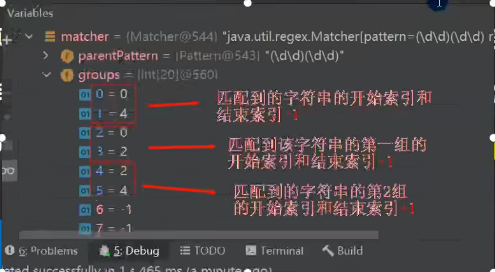
3、分组groups[0]、group[1]理解
4、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;
public class Regexp_ {
    public static void main(String[] args) {
//        表示任意一个数字
        Pattern pattern = Pattern.compile("(\\d\\d)(\\d\\d)");
        String content = "1996年1月,Sun公司发布了Java的第一个开发工具包(JDK 1.0),这是Java发展历程中的重要里程碑,标志着Java成为一种独立的开发工具。9月,约8.3万个网页应用了Java技术来制作。10月,Sun公司发布了Java平台的第一个即时(JIT)编译器。\n" +
                "1997年2月,JDK 1.1面世,在随后的3周时间里,达到了22万次的下载量。4月2日,Java One会议召开,参会者逾一万人,创当时全球同类会议规模之纪录。9月,Java Developer Connection社区成员超过10万。\n" +
                "1998年12月8日,第二代Java平台的企业版J2EE发布。1999年6月,Sun公司发布了第二代Java平台(简称为Java2)的3个版本:J2ME(Java2 Micro Edition,Java2平台的微型版),应用于移动、无线及有限资源的环境;J2SE(Java 2 Standard Edition,Java 2平台的标准版),应用于桌面环境;J2EE(Java 2Enterprise Edition,Java 2平台的企业版),应用于基于Java的应用服务器。Java 2平台的发布,是Java发展过程中最重要的一个里程碑,标志着Java的应用开始普及。";
        int no =0;
//
        Matcher matcher = pattern.matcher(content);
//        循环
        while(matcher.find()){
/*
            小结
            1、如果正则表达式有()即分组
            2、取出匹配的字符规则如下
            3、group(0)表示匹配到的字符串
            4、group(1)表示匹配到的字符串的第一组字串
            5、group(2)表示匹配的字符串的第2组字串
            6、分组数不能越界
 */
            System.out.println("找到:"+" "+matcher.group(1));
            System.out.println("找到:"+" "+matcher.group(2));
            System.out.println("找到:"+(++no)+" "+matcher.group(0));
//            System.out.println("找到:"+(++no)+" "+matcher.group(3))/;越界了
        }

    }
}
4、正则表达式语法
4.1、基本介绍
必须了解各种元字符的功能
4.2、元字符(Metacharacter)转义号
1、符号说明:正则表达式检索某些特殊字符串的时候,需要用到转移符号,否则检索不到结果。或者报错
2、转义符号:"\\"正则表达式是两个,java是一个
3、常见需要用到转义字符有:.*+()$/\?[]^{}
4、注意:[]中的.表示本身
(1)"."表示匹配所有字符
4、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp02 {
    public static void main(String[] args) {
        String content = "abc(111(111(111(222(34445";
        //匹配(
        String regStr="\\(";//其中\\就是转义字符
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        while (matcher.find()){
            System.out.println("找到"+matcher.group(0));
        }
    }
}
4.3、元字符-字符匹配符
1、内容
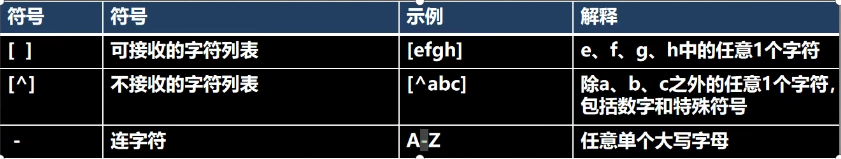
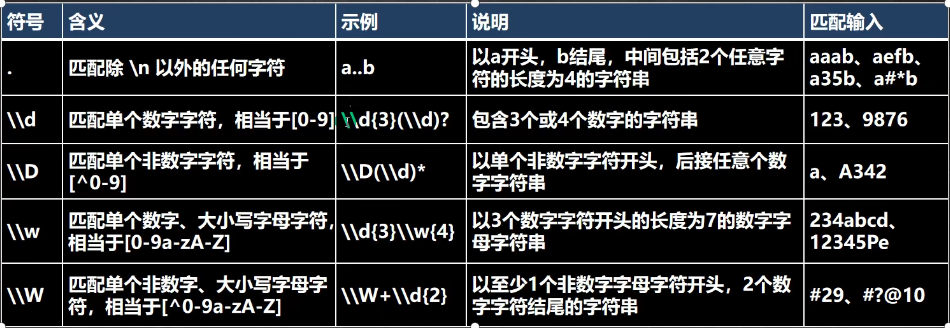
2、实例
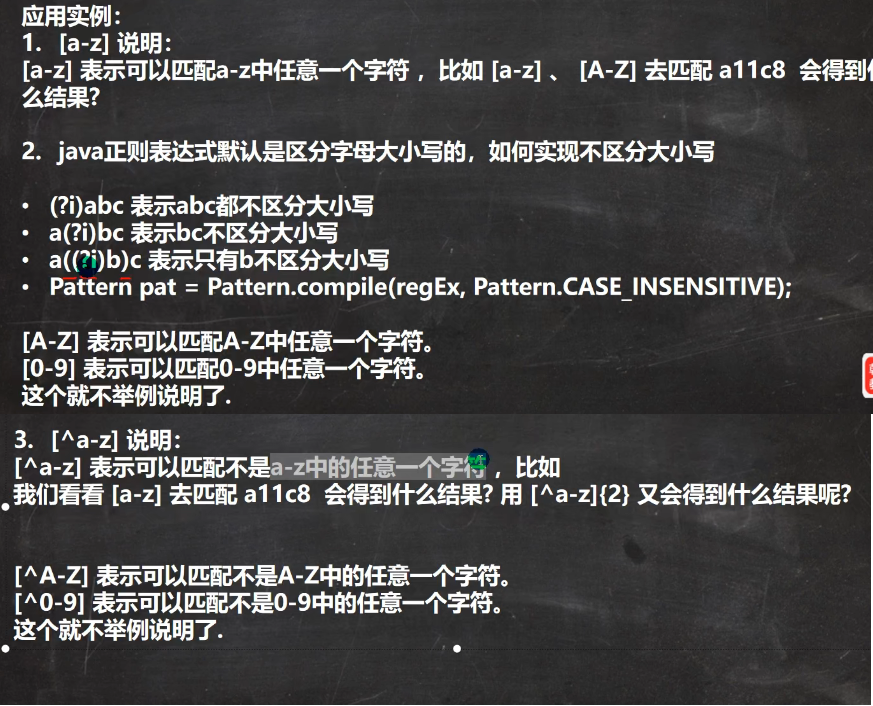
3、代码实现
import java.util.regex.Matcher;
import java.util.regex.Pattern;

/**
 * 演示字符串匹配符使用
 */
public class RegExp03 {
    public static void main(String[] args) {
        String content = " @@aadAaDladAADDGSSEfsdfga124234lc9";
//        String regStr = "[a-z]";//需要匹配的a-z任意字符
//        String regStr = "[A-Z]";//需要匹配的A-Z任意字符
//        String regStr = "a";//默认大小写区分
//        匹配不区分大小写
//        String regStr = "(?i)a";//不区分大小写,方法一
//        String regStr = "a(?i)d";//不区分大小写,方法一
//        String regStr = "[^a-z]";//匹配不在a-z之间任意一个字符
//        String regStr = "[abcd]";//匹配在abcd中任意一个字符
//        String regStr = "\\D";//匹配非数字字符
//        String regStr = "\\w";//匹配在任意字母、数字、下划线
//        String regStr = "\\W";//匹配和w取反操作
//        String regStr = "\\s";//匹配空白字符
//        String regStr = "\\S";//匹配和s取反
        String regStr = ".";//匹配除了\n其他都可以匹配

//      创建对象时,制定Pattern.CASE_INSENSITIVE,表示匹配是不区分大小写的
//        Pattern pattern = Pattern.compile(regStr,Pattern.CASE_INSENSITIVE);
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        while(matcher.find()){
            System.out.println("找到"+matcher.group(0));
        }
    }
}
4.4、元字符-选择匹配符
1、内容
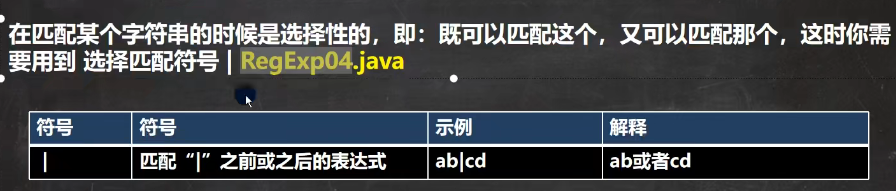
2、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp04 {
    public static void main(String[] args) {
        String content ="qintao 琴 秦涛";
        String regStr= "qin|琴|秦涛";
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到"+matcher.group(0));
        }
    }
}
4.5、元字符-限定符
1、内容
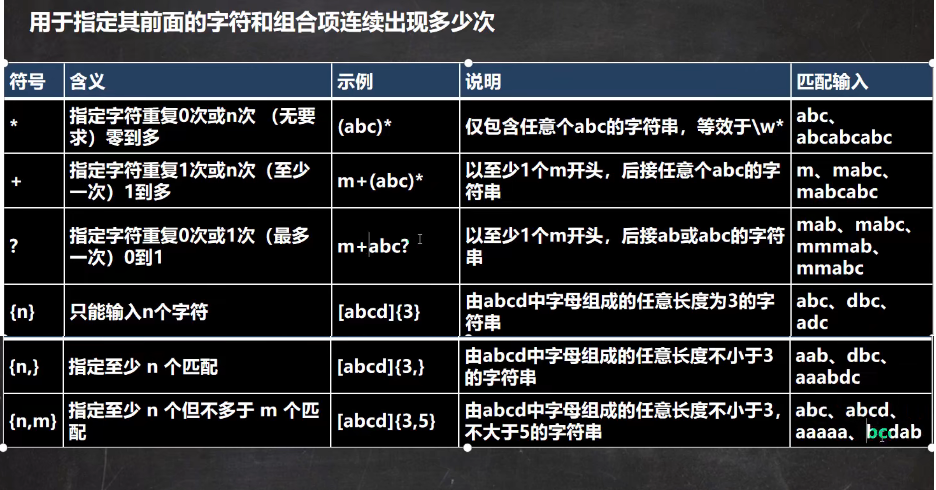
细节:java匹配默认是贪婪匹配,尽可能匹配多的
2、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp05 {
    public static void main(String[] args) {
        String content ="11141111a1aa1aaaaa";
//        String regStr="a{3}";//表示匹配aaa
//        String regStr="1{5}";//表示匹配11111
//        String regStr="\\d{3}";//表示匹配3个任意数字字符
        //细节:java匹配默认是贪婪匹配,尽可能匹配多的
//        String regStr="1{3,4}";//表示匹配111 或者1111
//        String regStr="1{2,5}";//2,3,4,5个
//        String regStr="1+";//匹配一个1或者多个1
//        String regStr="\\d+";//匹配一个数字或者多个数字
//        String regStr="1*";//匹配0个1 或者多个1
//      演示?的使用
        String regStr="a1?";//匹配a或者a1

        Pattern pattern  = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        while(matcher.find()){
            System.out.println("找到"+matcher.group(0));
        }
    }
}
4.6、元字符-定位符
1、内容
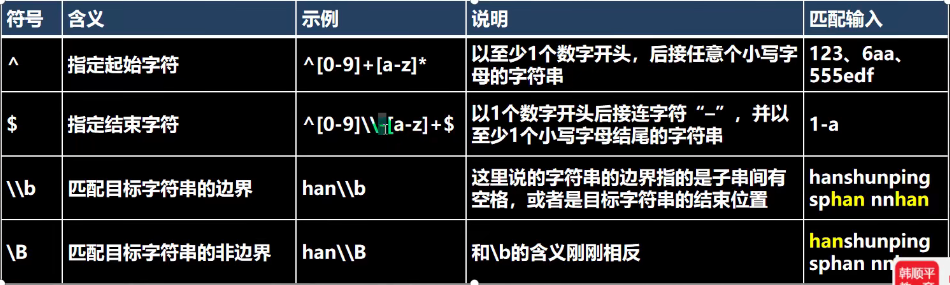
2、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp06 {
    public static void main(String[] args) {
//        String content ="123-abc";
        String content ="wc wcwawc nsdashaguawc";
//        以至少1个数字开头,后接任意个小写字母字符串
//        String regStr = "^[0-9]+[a-z]*";
//        以至少1个数字开头,必须以至少一个小写字母结束
//        String regStr = "^[0-9]+[a-z]+$";
//        String regStr = "^[0-9]+-[a-z]*";

//        表示匹配边界的行wc ,这里的边界是指:被匹配的字符串最后,也可以是
//        空格的子字符串的后面
        String regStr = "wc\\B";

        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        while (matcher.find()){
            System.out.println("找到: "+matcher.group(0));
        }
    }
}
5、正则表达式—捕获分组和非捕获分组
5.1、捕获分组
1、就是可以用命名来进行分组
2、格式
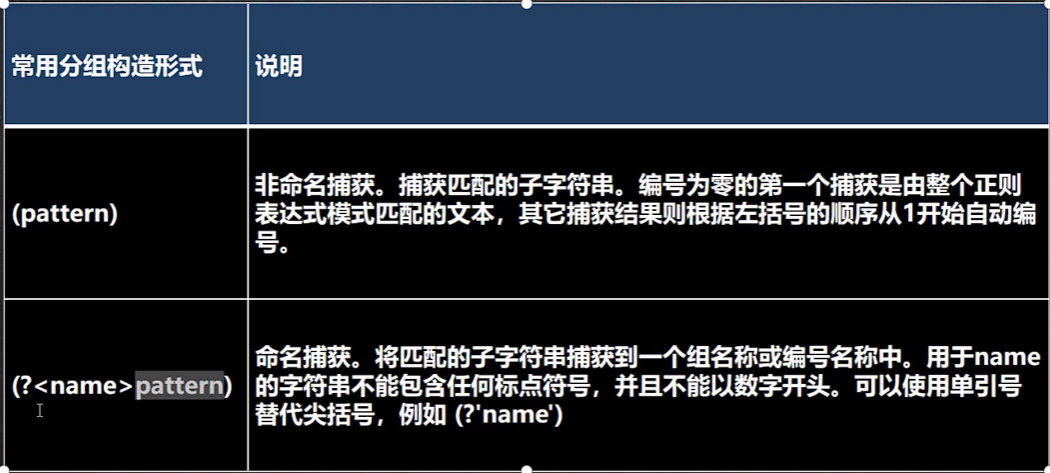
3、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp07 {
    public static void main(String[] args) {
        String content ="11223344";
        String regStr = "(?<g1>\\d\\d)(?<g2>\\d\\d)";
        Pattern pattern = Pattern.compile(regStr);

        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("通过下标找到"+matcher.group(0));//表示所有
            System.out.println("通过组名找到"+matcher.group("g1"));
            System.out.println("通过下标找到"+matcher.group(1));
            System.out.println("通过组名找到"+matcher.group("g2"));
        }
    }
}
5.2、非捕获分组(特别分组)
1、内容
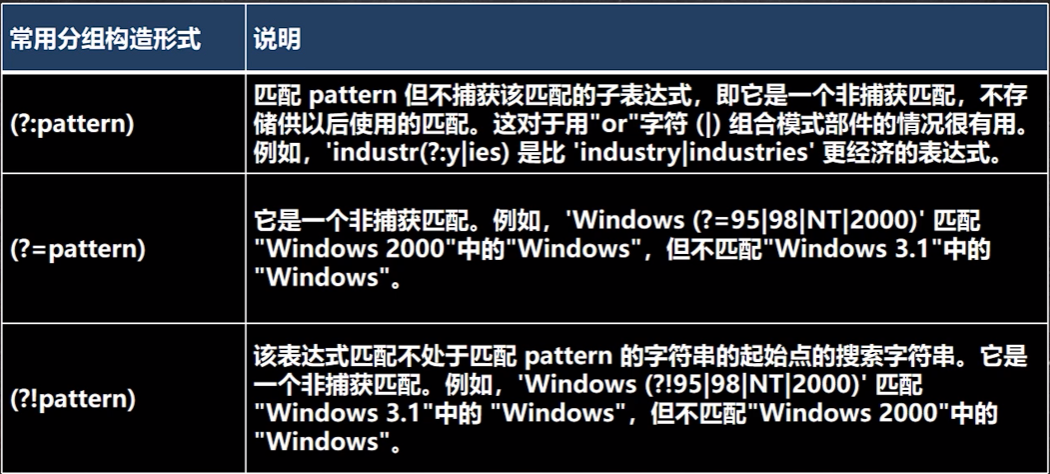
2、注意:以上三个都是非捕获分组,无法通过组名来获取内容
3、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp08 {
    public static void main(String[] args) {
        String content ="aa秦涛大哥、bb秦涛善良、cc秦涛帅气、dd我喜欢人";

//        题目1、找到秦涛大哥,秦涛善良,秦涛帅气
//        非捕获分组,不能使用组名获取
//        String regStr = "秦涛(?:大哥|帅气|善良)";

//        题目2、找到秦涛大哥、秦涛帅气,不要秦涛善良
//        非捕获分组,不能使用组名获取
//        String regStr = "秦涛(?=大哥|帅气)";

//        题目3、找到秦涛善良,不要秦涛帅气,秦涛大哥,和上一题取反
//        非捕获分组,不能使用组名获取
        String regStr = "秦涛(?!大哥|帅气)";

        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到:"+ matcher.group(0));

        }

    }
}
6、正则表达式—非贪婪匹配
1、内容:+?
2、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

/**
 * 非贪婪匹配
 */
public class RegExp09 {
    public static void main(String[] args) {
        String content = "aaaaaaaaaaaaaaaa";
//        String regStr = "\\w+"; //默认贪心算法匹配,匹配最多的字符
        String regStr = "\\w+?";//非贪心算法匹配

        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到了:"+matcher.group(0));
        }
    }
}
7、正则表达式实例
7.1、题目
(1)验证汉字(找到汉字范围:\u0339-\uffe5)
 String content = "啊啊大领导会计法";
 String regStr = "^[\u0339-\uffe5]+$";
(2)邮政编码:要求1-9开头的6位数
String content = "122222";
String regStr ="^[1-9]\\d{5}$";
(3)qq号码:1-9开头的眼光(5-10)位数
String content = "12222212";
String regStr = "^[0-9]\\d{4,9}$";
(4)手机号码:必须13/14/15/18开头的11位数字
String content = "13222212134";
String regStr = "^1(?:3|4|5|8)\\d{9}$";
String regStr = "^1[3|4|5|8]\\d{9}$";
7.2、复杂URL地址匹配
1、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp11 {
    public static void main(String[] args) {
        String content = "https://www.bilibili.com/video/BV1Eq4y1E79W?p=17&spm_id_from=pageDriver&vd_source=39acca4b6208d4992ddb44c1032e9230";
        String regStr = "^((http|https)://)?([\\w-]+\\.)+[\\w-]+(\\/[\\w-?=#&/%.]*)?$";//在[]中的字符表示的是本身

        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        if(matcher.find()){
            System.out.println(matcher.group(0)+"匹配成功");
        }else{
            System.out.println("匹配失败");
        }
    }
}
2、说明
(1)在[]中的字符表示的是本身
7.3、结巴去重案例
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp13 {
    public static void main(String[] args) {
        String content= "我...我要....学学学...编程java!";

//        方法一:
        Pattern pattern = Pattern.compile("\\.");
        Matcher matcher = pattern.matcher(content);

        content = matcher.replaceAll("");
        System.out.println("替换结果为:"+content);

//        去掉相同的文字
        /*
        思路
        使用(.)\\1+来匹配相同的字
        反向引用$1来替换匹配到的内容,就是外部
         */
        pattern =Pattern.compile("(.)\\1+");
        matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到了:"+matcher.group(0));//找到了重复的
        }
//        使用反向引用$1来替换匹配到的字符
        content = matcher.replaceAll("$1");
        System.out.println("content="+content);

//        方法二、
        content = Pattern.compile("(.)\\1+").matcher(content).replaceAll("$1");
        System.out.println("找到:"+content);
    }
8、正则表达式三个常用类
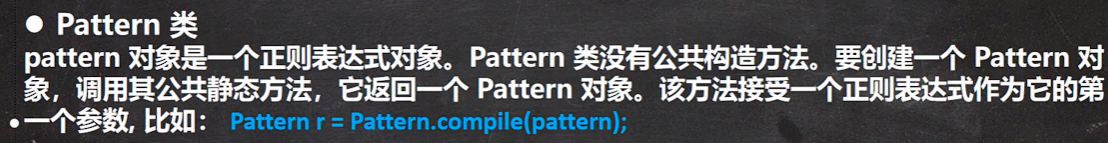
8.1、Pattern类
1、介绍
2、常用方法
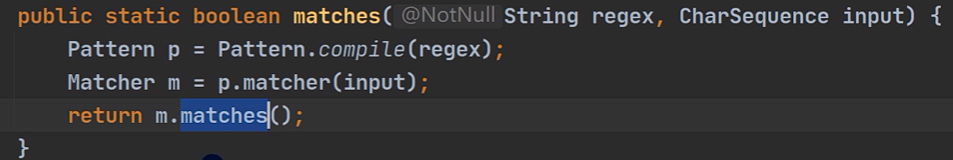
1、matcher(匹配规则,匹配内容);较为简单,返回boolean值,且可以省略^$定位符
(1)底层
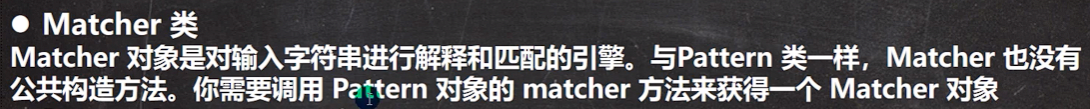
8.2、Matcher类
1、介绍
2、常用方法
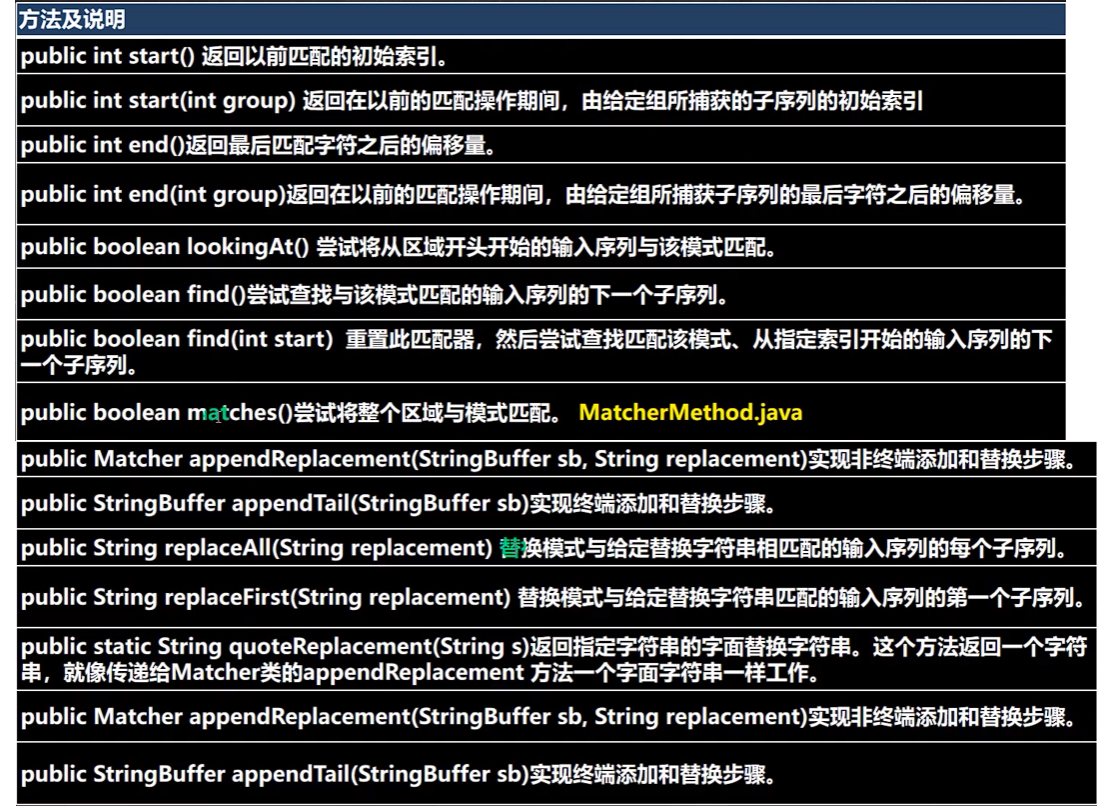
3、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class MatcherMethod {
    public static void main(String[] args) {
        String content = "hello edu jack tom hello smith qt dasb dasb ";
        String regStr ="hello";

        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);

        while (matcher.find()){
            System.out.println("=============================");
            System.out.println(matcher.start());//返回匹配到的首个位置
            System.out.println(matcher.end());//返回匹配到的尾位置

        }
//        如果有dasb就替换成nsa
        regStr ="dasb";
        pattern =Pattern.compile(regStr);
        matcher =pattern.matcher(content);
//        注意,返回字符串才是替换后的字符串,原本不变化
        String newContent = matcher.replaceAll("nsa");
        System.out.println("原本的:"+content);
        System.out.println("新的字符串是:"+newContent);

    }
}
8.3、PatternSyntaxException类
1、介绍

9、分组、捕获、反向引用
9.1、介绍
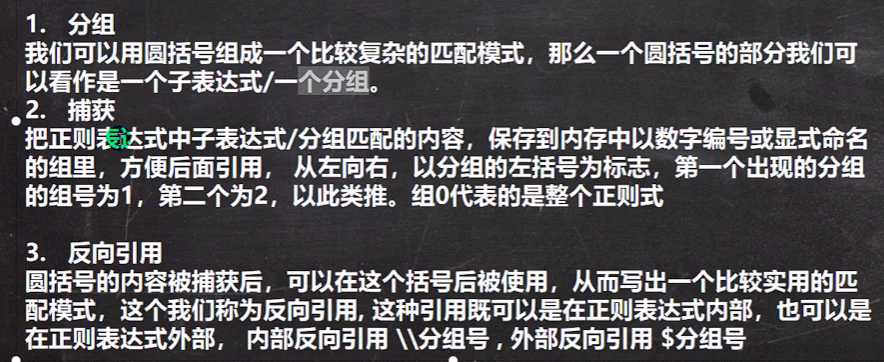
9.2、反向引用
1、引入例子
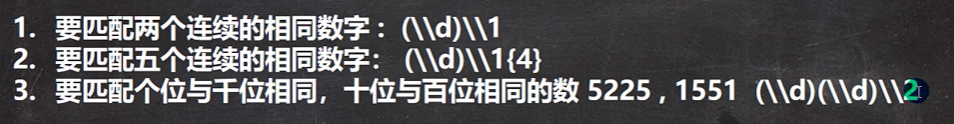
2、注意:反向引用需要分组或者捕获后,\\(反向引用符号)x(x表示位数)
3、理解
(1)例:
String regex = "^(\d)\1$";
首先这里是匹配两位,\d一位,\1又引用\d一位 这里的\1会去引用(\d)匹配到的内容,因为(\d)是第一次匹配到的内容。
如:str = "22"时,(\d)匹配到2,所以\1引用(\d)的值也为2,所以str="22"能匹配
str = "23"时,(\d)匹配到2,因为\1引用(\d)的值2,而这里是3,所以str="23"不能匹配
4、例子
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class RegExp12 {
    public static void main(String[] args) {
//        String content = "hell 11111 24 4364 1234";
//        作用,找到连续相同的数字
//        String regStr = "(\\d)\\1";

//        找到连续相同的5个数
//        String regStr = "(\\d)\\1{4}";

/*
        请在字符串中检索商品称号,形式如123321-333666888
        要求前面满足一个五位数和-。和9位数,每3位相同
 */
        String content = "12321-333666888";
        String regStr = "\\d{5}-(\\d)\\1{2}(\\d)\\2{2}(\\d)\\3{2}"; //其中\\x,x就是分组后的下标
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到:"+matcher.group(0));
        }
    }
}
10、正则表达式—替换分割匹配
10.1、替换匹配
1、replaceAll(匹配规则,匹配内容)
(1)例子
public class StringReg {
    public static void main(String[] args) {
        String content = "jdk1.3  jdk1.5";
        content = content.replaceAll("JDK1\\.3|JDK15","jdk");
        System.out.println(content);
        content ="13813334644";
        if(content.matches("1(38|39)\\d{8}")){
            System.out.println("验证成功");
        }else {
            System.out.println("验证失败");
        }

    }
}
10.2、分割功能
1、splitt(String 匹配规则)
2、例子
public class StringReg {
    public static void main(String[] args) {
        String content = "jdk1.3  jdk1.5";
        content = content.replaceAll("JDK1\\.3|JDK15","jdk");
        System.out.println(content);
        content ="13813334644";
        if(content.matches("1(38|39)\\d{8}")){
            System.out.println("验证成功");
        }else {
            System.out.println("验证失败");
        }
//        根据特殊符进行分割
        content = "hello#abc-aaa-smith~北京";
        String []  split = content.split("#|-|~");
        for(String s :split){
            System.out.println(s);
        }
    }
}
10.3、家庭作业
1、验证邮箱
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class homeWork01 {
    public static void main(String[] args) {
        String content = "1s_-@sss.com";
        String regStr ="^[\\w\\-]+@?([a-zA-Z]+\\.)+[a-zA-Z]+$";
        Pattern pattern =Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        if(matcher.find()){
            System.out.println("找到:"+content);
        }else {
            System.out.println("失败");
        }
    }
}
2、匹配整数或小数
/**
 * 要求:验证是不是整数或者小数
 * 提示:考虑整数和负数
 * 例如:123 -345  34.89 -89.9 -0.01 0.45
 */
public class HomeWork02 {
    public static void main(String[] args) {
        String content = "123.666";//整体匹配,单个值
        String regStr = "^[+-]?([1-9]\\d*|0\\d)(\\.\\d+)?$";
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        if(matcher.find()){
            System.out.println("成功找到");
        }else {
            System.out.println("失败,找不到");
        }
    }
}
3、截图地址的协议、域名、端口号、文件名
import java.util.regex.Matcher;
import java.util.regex.Pattern;

public class HomeWork03 {
    public static void main(String[] args) {
        String content ="http://www.sohu.com:8080/abc/inde@#$%^&*()x.htm";
        String regStr = "^([a-zA-Z]+)://([a-zA-Z.]+):(\\d+)[\\w-/]*/([\\w.@#$%^&*()]+)$";
        Pattern pattern = Pattern.compile(regStr);
        Matcher matcher = pattern.matcher(content);
        while (matcher.find()){
            System.out.println("找到协议:"+matcher.group(1));//
            System.out.println("找到域名:"+matcher.group(2));
            System.out.println("找到端口号:"+matcher.group(3));
            System.out.println("找到文件名:"+matcher.group(4));
        }
    }
}
11、正则表达式大全
一、校验数字的表达式
1、 数字:^[0-9]*$
2、 n位的数字:^\d{n}$
3、 至少n位的数字:^\d{n,}$
4、 m-n位的数字:^\d{m,n}$
5、 零和非零开头的数字:^(0|[1-9][0-9]*)$
6、 非零开头的最多带两位小数的数字:^([1-9][0-9]*)+(.[0-9]{1,2})?$
7、 带1-2位小数的正数或负数:^(-)?\d+(.\d{1,2})?$
8、 正数、负数、和小数:^(-|+)?\d+(.\d+)?$
9、 有两位小数的正实数:^[0-9]+(.[0-9]{2})?$
10、 有1~3位小数的正实数:^[0-9]+(.[0-9]{1,3})?$
11、 非零的正整数:^[1-9]\d$ 或 ^([1-9][0-9]){1,3}$ 或 ^+?[1-9][0-9]*$
12、非零的负整数:^-[1-9][]0-9"$ 或 ^-[1-9]\d$
13、 非负整数:^\d+$ 或 ^[1-9]\d*|0$
14、 非正整数:^-[1-9]\d*|0$ 或 ^((-\d+)|(0+))$
15、 非负浮点数:^\d+(.\d+)?$ 或 ^[1-9]\d.\d|0.\d[1-9]\d|0?.0+|0$
16、 非正浮点数:^((-\d+(.\d+)?)|(0+(.0+)?))$ 或 ^(-([1-9]\d.\d|0.\d[1-9]\d))|0?.0+|0$
17、 正浮点数:^[1-9]\d.\d|0.\d[1-9]\d$ 或 ^(([0-9]+.[0-9][1-9][0-9])|([0-9][1-9][0-9].[0-9]+)|([0-9][1-9][0-9]))$
18、 负浮点数:^-([1-9]\d.\d|0.\d[1-9]\d)$ 或 ^(-(([0-9]+.[0-9][1-9][0-9])|([0-9][1-9][0-9].[0-9]+)|([0-9][1-9][0-9])))$
19、 浮点数:^(-?\d+)(.\d+)?$ 或 ^-?([1-9]\d.\d|0.\d[1-9]\d|0?.0+|0)$
二、校验字符的表达式
1、 汉字:^[\u4e00-\u9fa5]{0,}$
2、 英文和数字:^[A-Za-z0-9]+$ 或 ^[A-Za-z0-9]{4,40}$
3、 长度为3-20的所有字符:^.{3,20}$
4、 由26个英文字母组成的字符串:^[A-Za-z]+$
5、 由26个大写英文字母组成的字符串:^[A-Z]+$
6、 由26个小写英文字母组成的字符串:^[a-z]+$
7、 由数字和26个英文字母组成的字符串:^[A-Za-z0-9]+$
8、 由数字、26个英文字母或者下划线组成的字符串:^\w+$ 或 ^\w{3,20}$
9、 中文、英文、数字包括下划线:^[\u4E00-\u9FA5A-Za-z0-9_]+$
10、 中文、英文、数字但不包括下划线等符号:^[\u4E00-\u9FA5A-Za-z0-9]+$ 或 ^[\u4E00-\u9FA5A-Za-z0-9]{2,20}$
11、 可以输入含有^%&',;=?$\"等字符:[^%&',;=?$\x22]+
12、 禁止输入含有~的字符:[^~\x22]+
三、特殊需求表达式
1、 Email地址:^\w+([-+.]\w+)@\w+([-.]\w+).\w+([-.]\w+)*$
2、 域名:[a-zA-Z0-9][-a-zA-Z0-9]{0,62}(/.[a-zA-Z0-9][-a-zA-Z0-9]{0,62})+/.?
3、 InternetURL:[a-zA-z]+://[^\s] 或 ^https://([\w-]+\.)+[\w-]+(/[\w-./?%&=])?$
4、 手机号码:^(13[0-9]|14[5|7]|15[0|1|2|3|5|6|7|8|9]|18[0|1|2|3|5|6|7|8|9])\d{8}$
5、 电话号码("XXX-XXXXXXX"、"XXXX-XXXXXXXX"、"XXX-XXXXXXX"、"XXX-XXXXXXXX"、"XXXXXXX"和"XXXXXXXX):^((\d{3,4}-)|\d{3.4}-)?\d{7,8}$
6、 国内电话号码(0511-4405222、021-87888822):\d{3}-\d{8}|\d{4}-\d{7}
7、 身份证号:
(1) 15或18位身份证:^\d{15}|\d{18}$
(2) 15位身份证:^[1-9]\d{7}((0\d)|(1[0-2]))(([0|1|2]\d)|3[0-1])\d{3}$
(3) 18位身份证:^[1-9]\d{5}[1-9]\d{3}((0\d)|(1[0-2]))(([0|1|2]\d)|3[0-1])\d{4}$
8、 短身份证号码(数字、字母x结尾):^([0-9]){7,18}(x|X)?$ 或 ^\d{8,18}|[0-9x]{8,18}|[0-9X]{8,18}?$
9、 帐号是否合法(字母开头,允许5-16字节,允许字母数字下划线):^[a-zA-Z][a-zA-Z0-9_]{4,15}$
10、 密码(以字母开头,长度在6~18之间,只能包含字母、数字和下划线):^[a-zA-Z]\w{5,17}$
11、 强密码(必须包含大小写字母和数字的组合,不能使用特殊字符,长度在8-10之间):^(?=.\d)(?=.[a-z])(?=.*[A-Z]).{8,10}$
12、 日期格式:^\d{4}-\d{1,2}-\d{1,2}
13、 一年的12个月(01~09和1~12):^(0?[1-9]|1[0-2])$
14、 一个月的31天(01~09和1~31):^((0?[1-9])|((1|2)[0-9])|30|31)$
15、 钱的输入格式:
16、 有四种钱的表示形式我们可以接受:"10000.00" 和 "10,000.00", 和没有 "分" 的 "10000" 和 "10,000":^[1-9][0-9]*$
17、 这表示任意一个不以0开头的数字,但是,这也意味着一个字符"0"不通过,所以我们采用下面的形式:^(0|[1-9][0-9]*)$
18、 一个0或者一个不以0开头的数字.我们还可以允许开头有一个负号:^(0|-?[1-9][0-9]*)$
19、 这表示一个0或者一个可能为负的开头不为0的数字.让用户以0开头好了.把负号的也去掉,因为钱总不能是负的吧.下面我们要加的是说明可能的小数部分:^[0-9]+(.[0-9]+)?$
20、 必须说明的是,小数点后面至少应该有1位数,所以"10."是不通过的,但是 "10" 和 "10.2" 是通过的:^[0-9]+(.[0-9]{2})?$
21、 这样我们规定小数点后面必须有两位,如果你认为太苛刻了,可以这样:^[0-9]+(.[0-9]{1,2})?$
22、 这样就允许用户只写一位小数.下面我们该考虑数字中的逗号了,我们可以这样:^[0-9]{1,3}(,[0-9]{3})*(.[0-9]{1,2})?$
23、 到3个数字,后面跟着任意个 逗号+3个数字,逗号成为可选,而不是必须:^([0-9]+|[0-9]{1,3}(,[0-9]{3})*)(.[0-9]{1,2})?$
24、 备注:这就是最终结果了,别忘了"+"可以用"*"替代如果你觉得空字符串也可以接受的话(奇怪,为什么?)最后,别忘了在用函数时去掉去掉那个反斜杠,一般的错误都在这里
25、 xml文件:^([a-zA-Z]+-?)+[a-zA-Z0-9]+\.[x|X][m|M][l|L]$
26、 中文字符的正则表达式:[\u4e00-\u9fa5]
27、 双字节字符:[^\x00-\xff] (包括汉字在内,可以用来计算字符串的长度(一个双字节字符长度计2,ASCII字符计1))
28、 空白行的正则表达式:\n\s*\r (可以用来删除空白行)
29、 HTML标记的正则表达式:<(\S?)[^>]>.?|<.? /> (网上流传的版本太糟糕,上面这个也仅仅能部分,对于复杂的嵌套标记依旧无能为力)
30、 首尾空白字符的正则表达式:^\s|\s$或(^\s)|(\s$) (可以用来删除行首行尾的空白字符(包括空格、制表符、换页符等等),非常有用的表达式)
31、 腾讯QQ号:[1-9][0-9]{4,} (腾讯QQ号从10000开始)
32、 中国邮政编码:[1-9]\d{5}(?!\d) (中国邮政编码为6位数字)
33、 IP地址:\d+.\d+.\d+.\d+ (提取IP地址时有用)