第五章、内存管理
1、内存介绍
1、存储单元
1、在机组中有
2、进程运行的基本原理
1、指令的工作原理—操作码+若干参数(可能包含地址参数)
1、就是指令执行,CPU经过编译会执行数据传送的指令
2、但是生成的机器指令不知道数据放在哪个位置,就要引出逻辑地址(相对地址)
2、逻辑地址
3、从写程序到程序运行—编译、链接、装入
1、图解
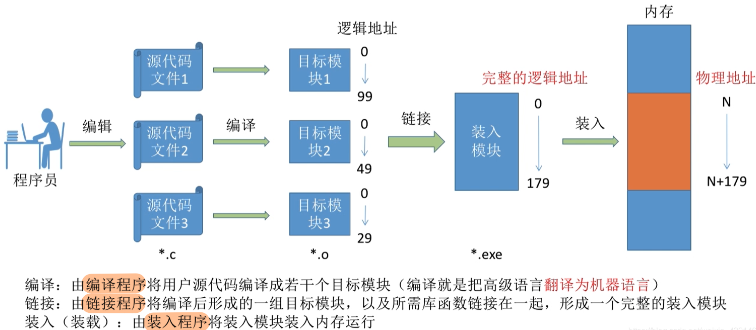
4、3种装入模式
1、就是三种不同方式,将逻辑地址转换为物理地址
2、绝对装入:在编译时,就知道程序放在内存中的哪个位置,编译程序就直接传输绝对地址的代码。
3、静态重定向:链接后装入模块的地址都是从0开始的,装入时根据内存方到适当的位置。然后进行"重定向",就可以把逻辑地址转换为物理地址。但是必须分配要求的全部内存空间,在运行期间就不能移动
4、动态重定向:唯一的区别就是把地址转换推迟到程序真正要执行时才进行。需要一个重定向寄存器的支持。
①允许程序在内存中发生移动
5、链路的三种方式
1、静态链路
①程序运行之前就将目标模块和函数库链接,不再分开。
2、装入时动态链接
就是将目标模块,边装入边链接
3、运行时动态链接
①就是用到的时候进行连接装入。
3、操作系统内存管理管理什么?
1、内存空间的分配与回收
2、内存空间的扩展(实现虚拟性)
1、提供某种技术从逻辑上对内存空间进行扩展
2、例如,玩游戏。一个游戏几十个G,我的运行内存只有16G。怎么玩?
3、地址转换
1、负责逻辑地址和物理地址的转换
2、地址重定向(三种方式)
1、三种方式。
1、上面提及了。
2、绝对地址、可重定位装入、动态运行时装入
4、内存保护(两种方式)
1、方式一:设置上下限寄存器
1、这对寄存器,用来存放进程的上、下限地址。防止越界
2、方式二:采用重定向寄存器
1、重定向寄存器(基址寄存器):存放起始物理地址
2、界地址寄存器(限长寄存器):存放最大逻辑地址
4、操作系统覆盖技术与交换技术
1、覆盖技术
解决程序大小超过了物理内存总和的问题
1、核心思想
1、将程序分为多段(多个模块)
2、经常用的模块就在内存,不经常用的就在需要的时候调用
3、一个固化区:存放常用的模块
4、若干个覆盖区:放不常用的模块
5、必须由程序员声明覆盖结构
6、缺点:对用户不透明
2、交换技术
1、就是三级调度
2、内存不够用了,系统将内存某些进程暂时换出外存,把外存具备运行条件的放入内存。
3、一般把系统分为文件区和对换区
4、文件区:存文件,追逐存储空间的利用率
5、对换区:被缓存的进程数据就放入对换区
6、PCB(进程控制块)会常驻内存,不然没办法还原进程被换出去,之后重新调用怎么换回来。
5、内存的分配与回收
1、分配
1、单一连续分配
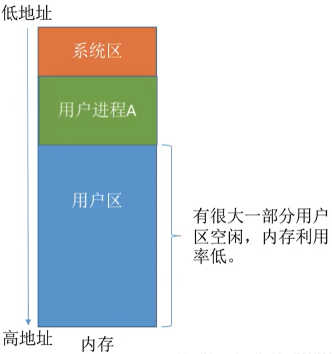
1、内存分为系统区和用户区
2、内存只能有一道用户程序,独占整个用户区
3、系统区一般放在低地址处
4、优点:简单实现,没有外部碎片
5、缺点:只能单用户、但任务的操作系统中。有内部碎片,存储器利用率低
6、图示
2、固定分区分配
1、将整个用户空间划分为若干固定大小的分区。
2、每个分区只装入一道作业
3、大小相同,但是不灵活。
4、适用于一台计算机控制多个相同对象的场合。
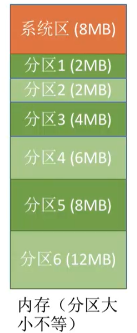
5、也有大小不相同的,相对灵活
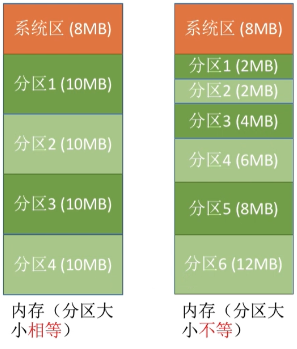
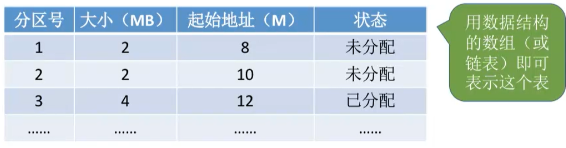
1、分区说明表
1、是一个数据结构,每个表项对应一个分区。
2、优点:实现简单,无外部碎片
3、缺点:
①程序太大了,可能所有分区都没办法满足,就会实现覆盖技术。但是会降低性能。
②会产生内部碎片
4、结构图
3、动态分区分配(可变分区分配)
1、可变分区分配
2、不会预先划分内存分区
3、而是在进程装入内存时,根据进程大小动态进行分配
1、系统要用怎样的数据结构记录内存的使用情况呢?
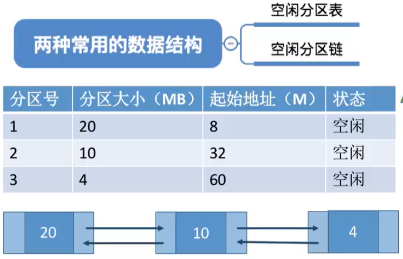
1、有2个数据结构:空闲分区表、空闲分区链
2、空闲分区表:用来记录那些内存的空闲状态的
3、空闲分区链(双向链表):每个空闲分区对应一个表现
4、里面包括:分区号、分区大小、起始地址、状态
5、如图
2、当多个空闲分区都能满足要求时,应该选择哪个分区进行分配?
1、下一小节研究
3、如何进行分区的分配和回收操作?
如何分配?
1 、分区大小相减,地址相加
2、例子:将进程5放入分区号为1的分区
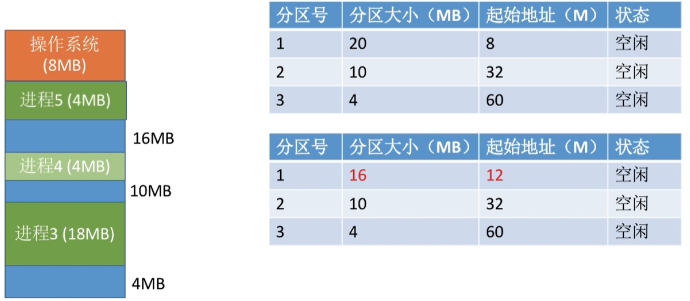
3、然后把空闲分区链中,相应的节点也删除掉。
如何回收?
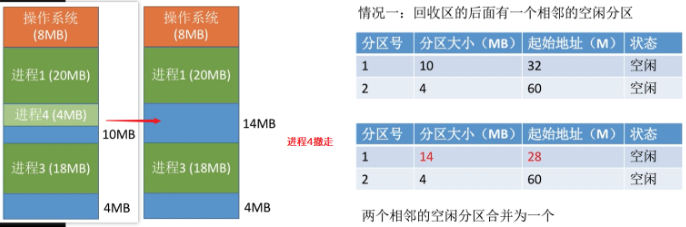
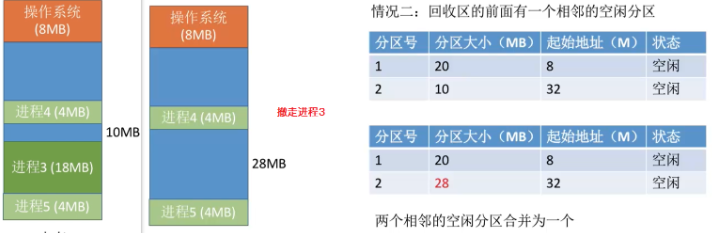
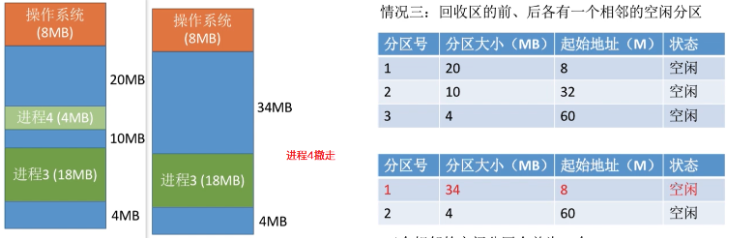
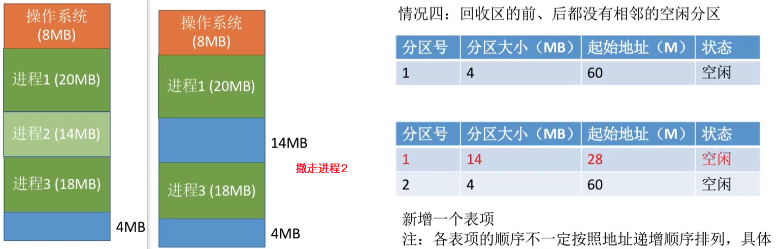
1、空闲分区+要走的分区,地址减掉
2、情况一:回收区的后面有一个相邻的空闲分区
①把两个相邻的空闲区合并为一个
②图示
3、情况二:回收区的前面有一个相邻的空闲分区
①图示
4、情况三:回收前、后各有一个相邻的空闲分区
①图示
5、情况四:回收区的前、后都没有相邻的空闲分区
①我们就需要新建一个表项
②具体排序方法要按照算法来确定
③图示
4、内部碎片与外部碎片
1、动态分区没有内部碎片、但是有外部碎片
2、内部碎片:就是一个内存表项中,一个进程有2M,内存表项有4M。所以就会有多余的空间。就是内部碎片。
3、外部碎片:一个内存中,两个进程之间夹杂的,太小的内存空闲分区,就是外部碎片。
4、可以通过紧凑(拼凑,Compaction)技术解决。
6、动态分区匹配算法
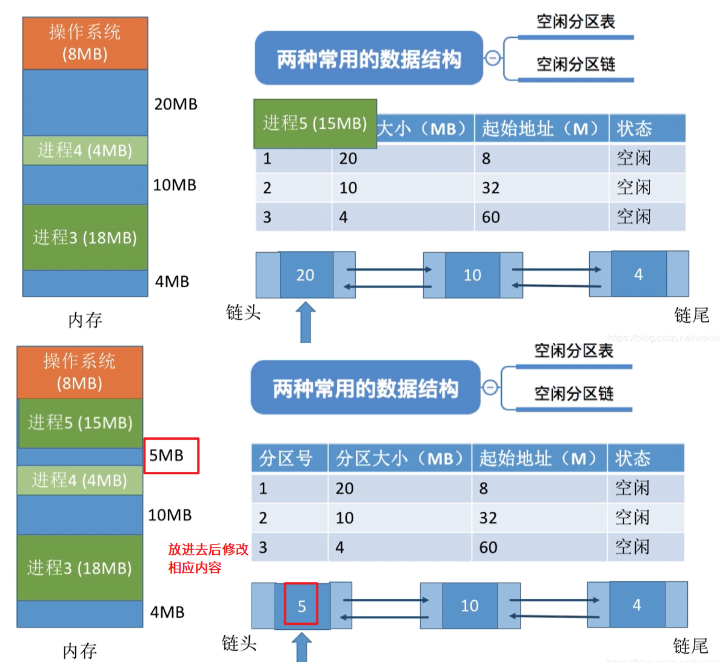
1、首次适应算法
1、思想:从低地址开始找,找到第一个满足大小的空闲分区
2、如何实现:空闲分区表按起始地址大小,进行从小到大排序,然后顺序查找空闲分区链(空闲分区表)。就能查到
3、例子
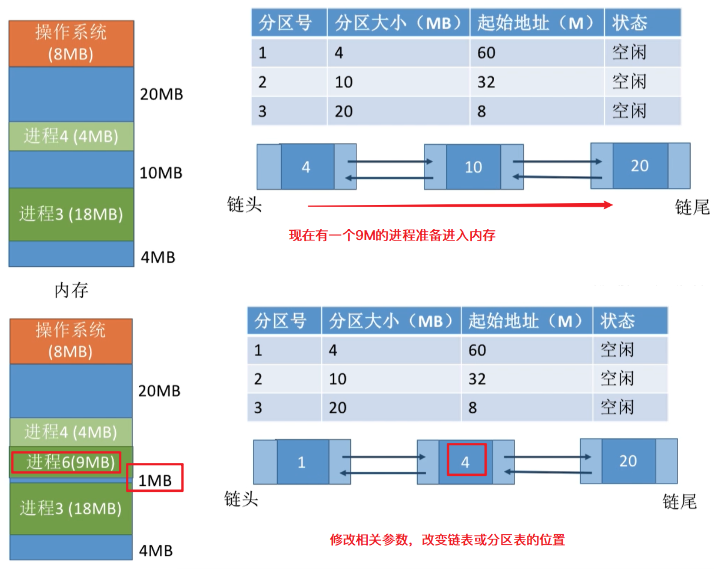
2、最佳适应算法
1、思想:就是从小内存分区开始找,找到第一个满足大小的空闲分区
2、如何实现:按容量的大小,递增。然后顺序查找空闲分区链(空闲分区表)。就能查到
3、例子
3、最坏(大)适应算法
1、思想:为解决最佳适应算法问题。每次分配使用最大连续空闲区。
2、如何实现:空闲分区按容量的大小依次递减,然后顺序查找空闲分区链(空闲分区表)。就能查到
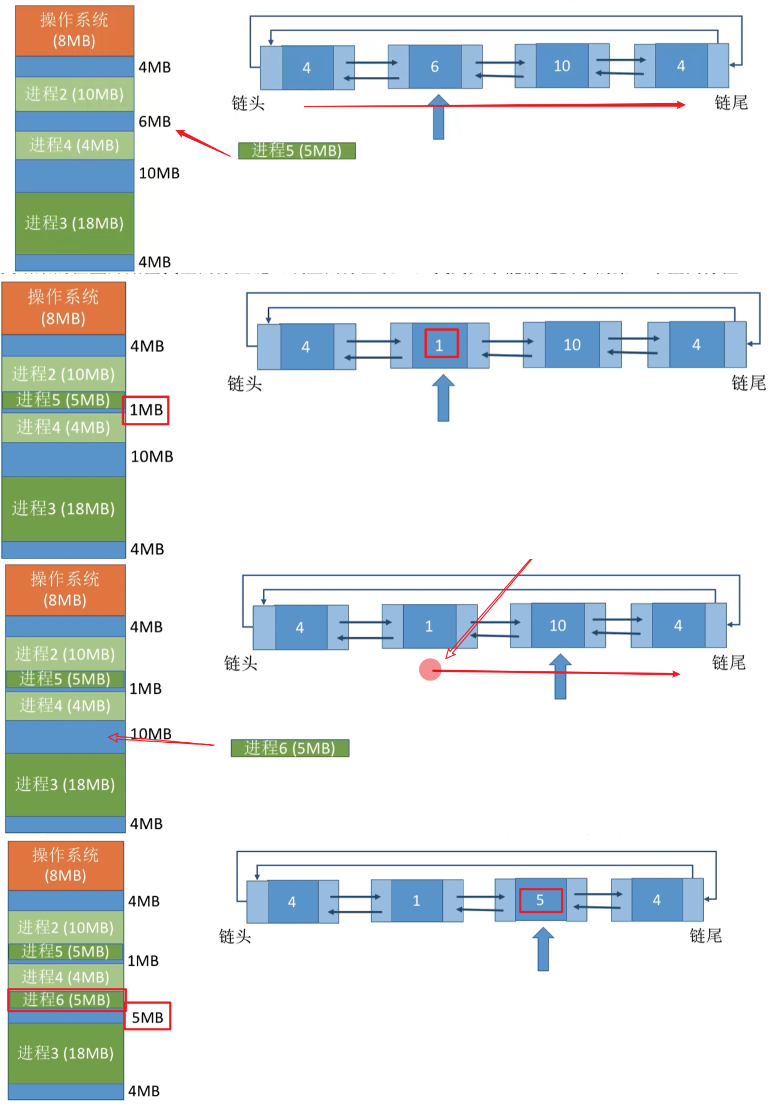
4、临近适应算法
1、思想:就是每次都从链表头开始找。可能会导致低地址出现很多空闲分区。也增加了查找的开销。
2、如何实现:把空闲分区以地址递增的顺序排列(一个循环链表)。每次分配空闲内存的时候,从上次查找结束的位置开始,查找空闲分区链。直到找到大小满足的。
3、例子
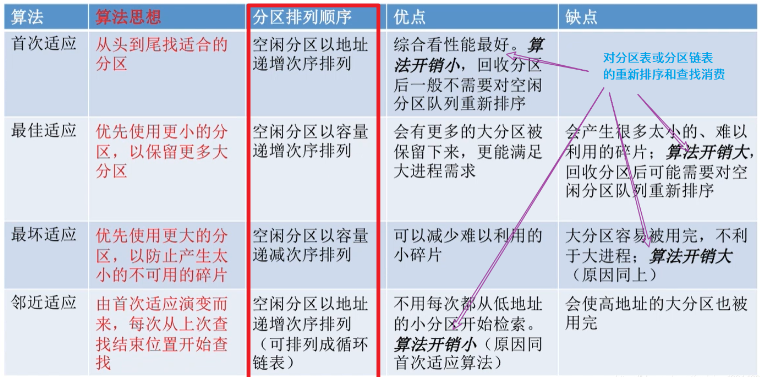
5、四种算法归纳比较
7、分页存储
1、为什么学习分页存储?
1、固定分区分配:缺乏灵活性,会产生大量内部碎片
2、动态分区分配:会产生很多外部碎片,紧凑技术会浪费时间
3、如果能将一个进程分散的装入许多不相邻的分区。就可以充分利用内存。
2、基本分页存储管理的思想
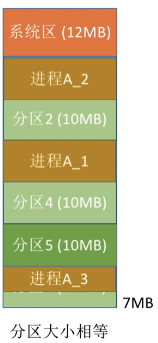
1、思想:就是将进程A为23MB的大小,每个分区只有10MB,如果进程只能占一个分区。放不下。就放在2个10MB的分区中,1个10MB的分区中。(分区不连续)
2、分区越小,资源利用率也就越大。
3、图示
3、分页存储管理的重要概念
1、内存分为若干相等的分区
2、每个分区就是一个“页框”、“页帧”、“内存块”、“物理块”
3、每个页框有一个编号:“页框号”、“内存块号”、“页帧号”、“物理块号”。编号从0开始
4、操作系统以页框为单位,为各个进程分配内存空间。
5、将用户进程的地址空间划分为,与页框大小相同的一个区域:称为“页”、“页面”。
6、每个页面也有一个编号,称为“页号”。
7、进程的页面与内存的页框有一一对应关系。
8、总结
- ①一个相等的内存分区就是一个页框;分区=页框;页框内有页框号
- ②分区地址=页面
4、如何实现地址的转换
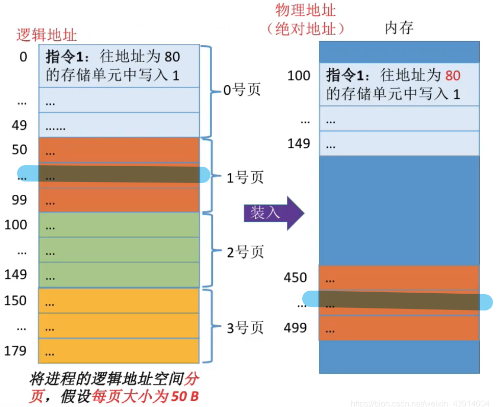
1、例如:往地址为80的内存单元存写入1
①80为逻辑地址,我们把页号(地址)分为50B。
②对应1号页,该页的内存中起始位置为450.
③逻辑地址为80对于该页来说应该是80-50=30。
④所以实际物理地址 = 450+30 =480
2、公式:物理地址=页面起始地址+页内偏移地址
①需要知道页号
②需要知道页号对应的起始位置
③需要知道页内的偏移地址
3、图示
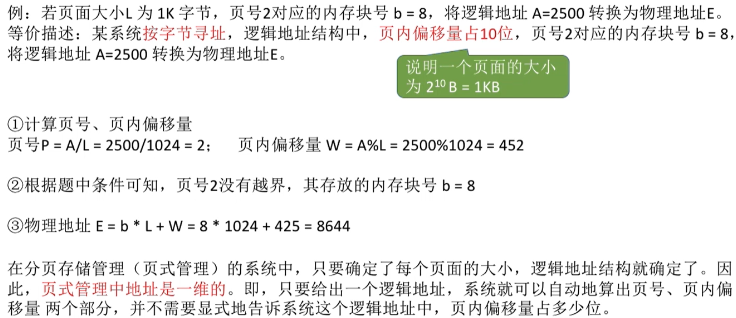
5、如何计算页号和页偏移量
1、页号怎么求:
①公式:逻辑地址 / 页面长度(取整数)
2、页内的偏移量如何求
①公式:逻辑地址 % 页面长度(取除法的余数部分)
3、页面在内存中的起始位置:题目会给。
4、例子(还是以上面那个80为例子)
①页号:80/50=1
②业内偏移地址:80%50 = 30
③起始地址:题目给了450
6、分页存储的逻辑结构
1、分页存储管理的逻辑地址结构如下图
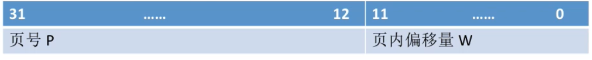
2、前一部分为页号,后一部分为页内偏移量W
3、例如地址长度为32位
4、0~11位为页内偏移量、12~21位为“页号”
7、如何知道页面在内存中的起始地址?
1、页表
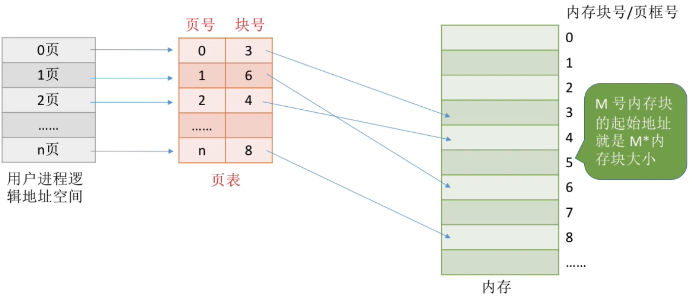
1、操作系统为每个进程建立一张页表。
2、目的:为了能知道进程的每个页面在内存中存放的位置
2、一个进程对应一张页表项
3、每个页表项由“页表”和“块号”组成
4、页表记录进程页面与实际存放的内存块之间的对应关系
5、每个页表项的长度是相同的,页号是隐含的。
6、总结
①相当于是每个进程都要分配一个空闲区,空闲区的地址也叫页面
②现在内存中需要存放页面。就要引出页表
③如图
8、分页存储管理的基本地址变换结构
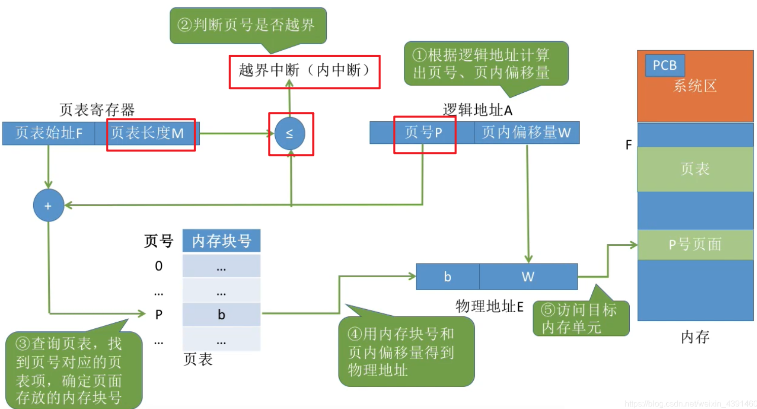
1、页表寄存器
1、基本地址交换机构,可以借助进程的页表将逻辑地址转换为物理地址。
2、通常会在系统中设置一个页表寄存器(PTR)。存放页表在内存中的起始地址F和页表长度M。
3、页面大小是2的整数幂
4、如何找到A的物理地址?
①图示
5、例子(重要)
9、快表地址变换结构
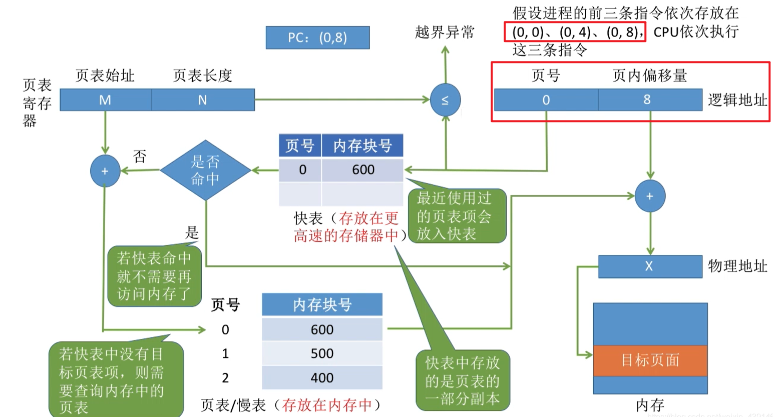
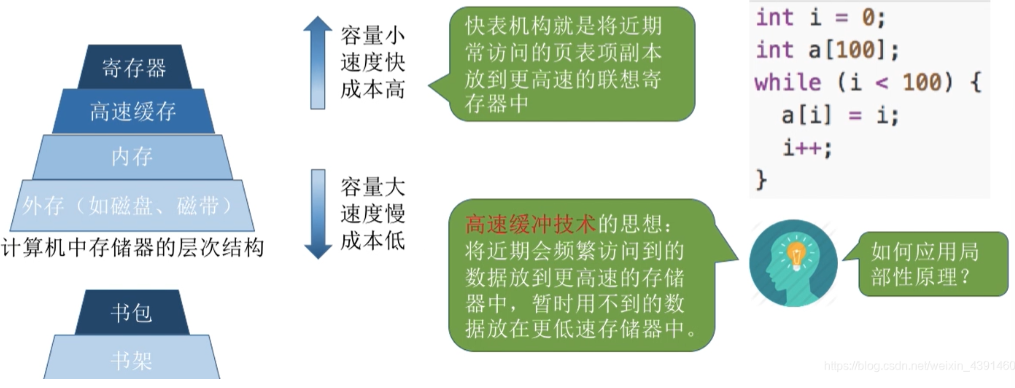
1、局部性原理引入快表机制
1、时间局部性:该指令被执行了,下次可能还会很快被执行;而且都是查询同一个逻辑地址。就需要引出快表机制
2、快表(TLB)
1、快表,又叫联想寄存器(TLB):访问速度比内存快的Cache存储器。
2、用来存放若干页表项。
3、其他内存中的表也叫慢表。
4、理解
①在进程有三条指令进程查询。
②开始时通过系统编译成页号,页内偏移量
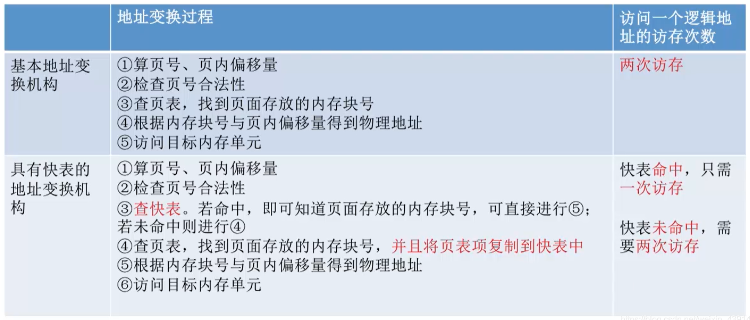
③再去找快表(更高速的存储器中)查找是否存在相同地址,如果有就直接将该地址(逻辑地址)+物理地址就找到了内存中所需要的东西
④如果快表中没有,就只能去慢表中找相应地址,然后该地址(逻辑地址)+物理地址就找到了内存中所需要的东西。这里找到后,会将该地址存入到快表中方便下次操作。
⑤如果快表慢了,就要按照算法替换快表中慢的东西。
⑥注意:如果中没有该东西,就需要访问两次访存,因为需要将该表存入到快表中。
5、图解
3、基本地址变换结构和快表地址变换结构的比较
10、二级页表的原理和结构地址
1、单级页表存在的问题
1、页表必须连续存放,因此页表很大的时候,需要占用很多个连续的页框
2、没有必要让整个页表常驻在内存中,因为进程在一段时间只需要用几个特定的页面
3、所以我们可以将页表进行分组。让每个内存块刚刚好放入一个分组。
4、要为离散分配的页表再建立一张页表:页目录表==外层页表==顶层页表
2、二级页表的原理和地址结构
解决问题上面的问题1:页表必须连续存放,因此页表很大的时候,需要占用很多个连续的页框。
1、就是将一个整块页表,再进行分组
2、图示
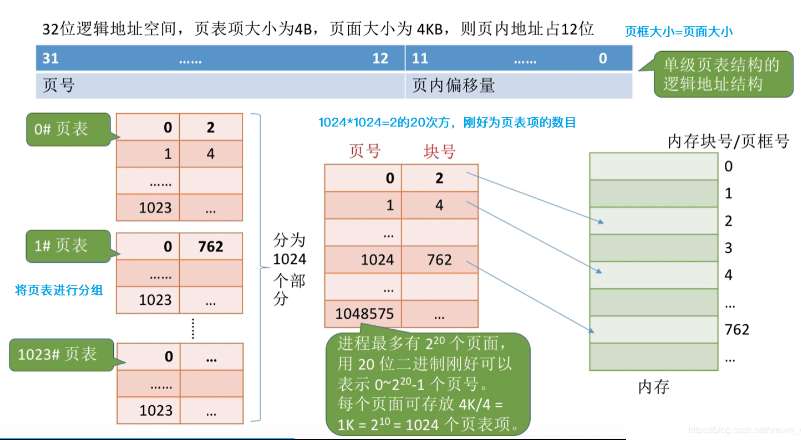
3、二级页表的地址结构及对应关系
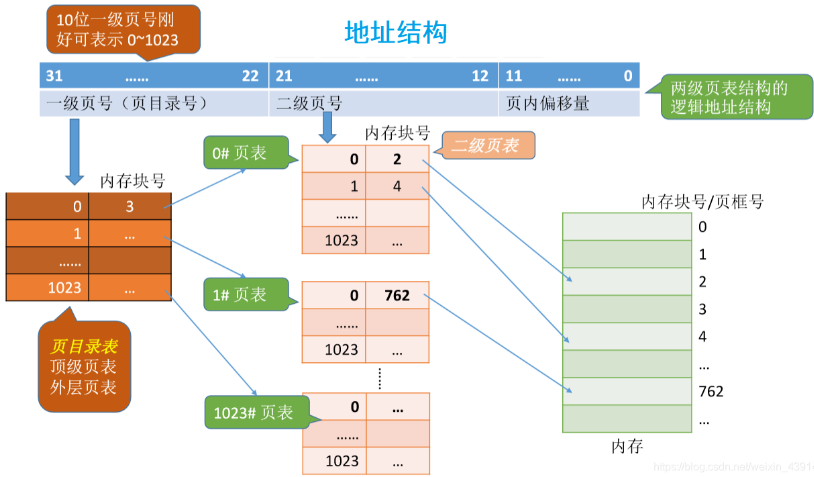
3、如何实现二级页表的地址变换
1、如图讲解
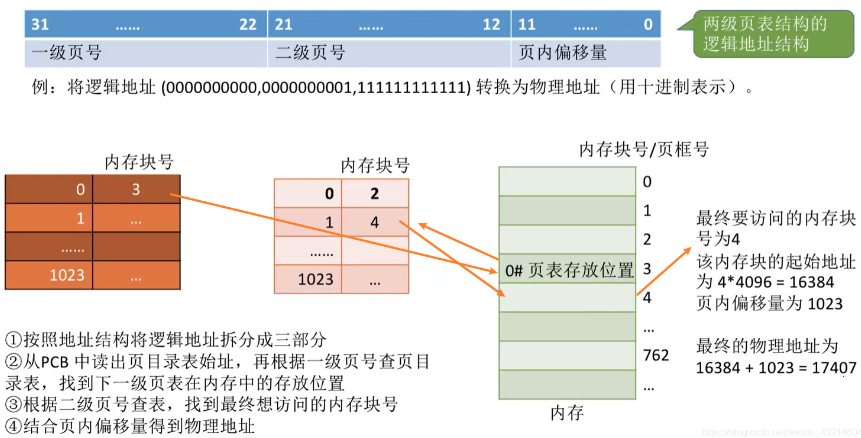
4、例题
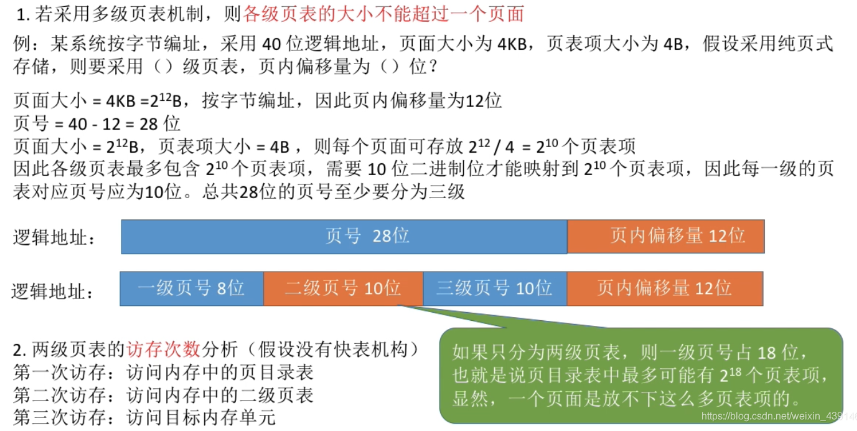
11、分段存储管理(段表、地址变换、信息共享)
1、什么是分段?
1、进程中的地址空间:按照程序自身逻辑关系划分若干段。每个段都有名字,从0开始
2、内存分配规则:以段为单位进行分配,每个段在内存中占据连续空间,各段可以不相邻。
3、如图所示:
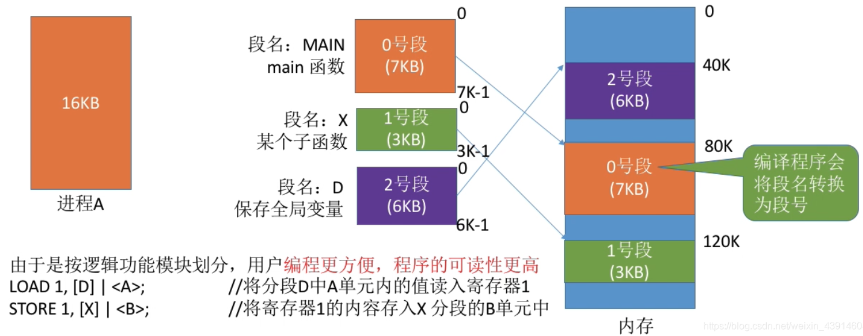
2、分段的逻辑地址结构
1、结构
| 31……16 | 15……0 |
|---|---|
| 段号 | 段内地址 |
2、段号的位数:决定了每个进程最多可以分几段
3、段内地址位数:决定了每个段最大长度是多少
2、段表
1、为什么要段表
①程序多个段分散的装入内存,为了保证程序能正常运行,就要找到 各个逻辑段的存放位置。需要建立衣阿华找那个段映射表,就叫段表
2、每个段对应有一个段表项,段表项里面记录了内存中的起始位置(基址)和段长度
3、各个段表项的长度是相同的
4、段号可以是隐含的,不占存储空间
5、如图
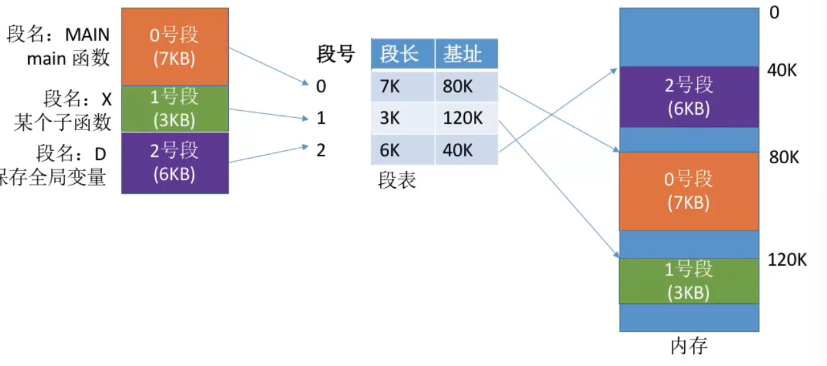
3、地址变换
1、通过CPU执行指令将逻辑地址转换为物理地址
2、图示
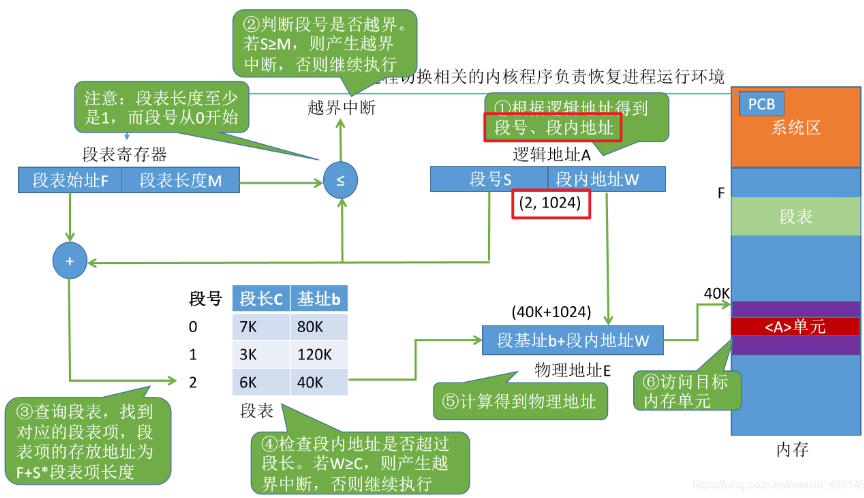
3、分段、分页管理的对比
| 对比 | 页 | 段 |
|---|---|---|
| 信息单位 | 物理单位(用户不可见) | 逻辑单位(用户可见) |
| 大小 | 长度固定 | 长度不固定,根据用户来写 |
| 地址空间 | 一维空间(只要一个记忆符) | 二维空间(要给出段名、段内地址) |
| 信息共享和保护 | 不容易 | 容易 |
| 访问几次内存 | 两次 | 两次(如果引入快表机构只要一次) |
1、纯代码=可重入代码:叫不能被修改的代码
2、可修改的代码不能共享
3、如图
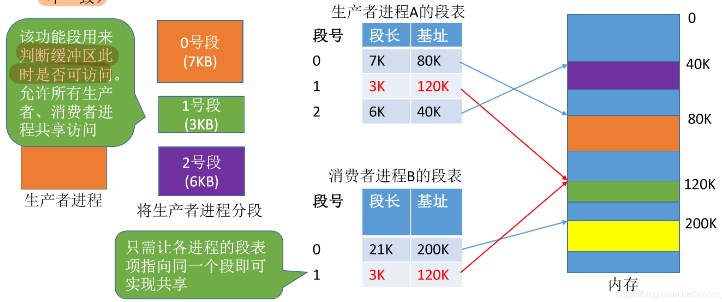
12、段页式存储管理
1、分页、分段的优缺点
| 优点 | 缺点 | |
|---|---|---|
| 分页管理 | 内存空间利用高,不会产生外部碎片,只有少量的页内碎片 | 不方便安装逻辑模块实现信息共享和保护 |
| 分段管理 | 方便安装逻辑模块实现信息共享和保护 | 段如果过长,为其分配很大的连续空间就不方便。段式管理会产生外部碎片(可以用紧凑来解决,但是会增加耗时) |
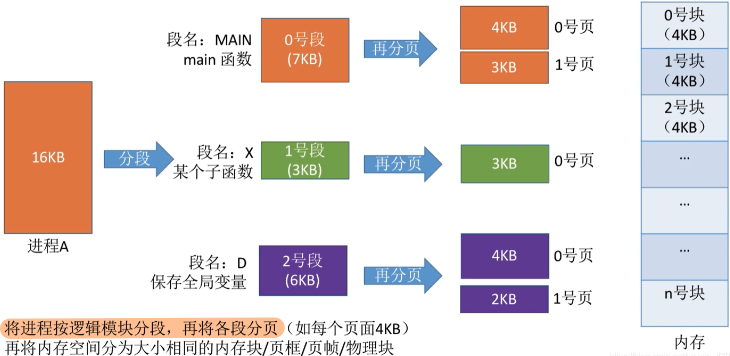
2、分段+分页=段页式管理
1、就是将内存先分块,分完块,再将块分为页,再将内存中分为大小相同的内存块/页框/页帧/物理块
2、如图
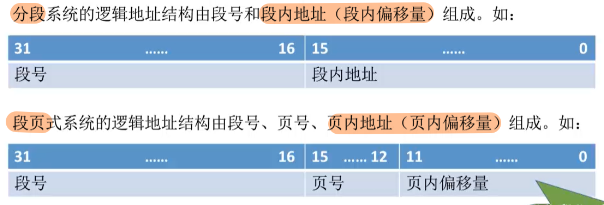
3、段页式管理的逻辑结构
1、段号的位数:每个进程最多可以分为几段
2、页号位数:决定每个段最大有多少页
3、页内偏移量:觉得页面的大小、内存块大小是多少
4、逻辑图
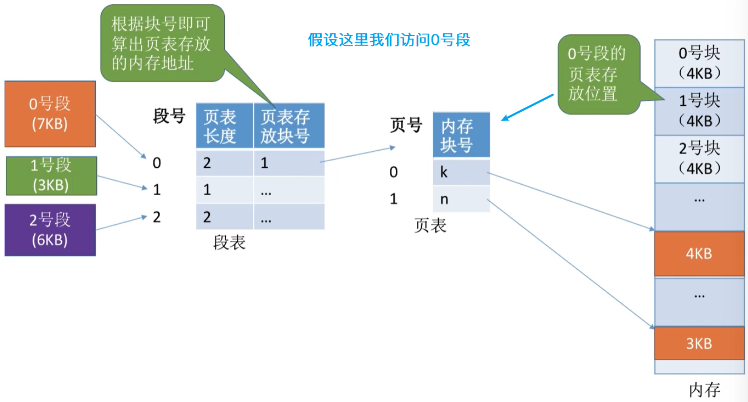
4、段页式存储的段表、页表
1、每个段对应一个段表项
2、段表项:段号、页表长度、页表存放块号(页表起始地址)
3、每个页面对应一个页表项,每个页表项由页号、页面存放的内存块号组成。每个页表项长度相等,页号是隐含的。
4、图示
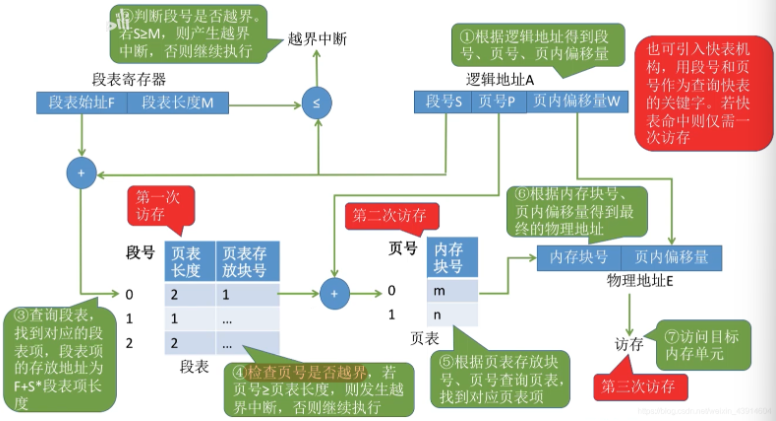
5、段页式管理的地址转换过程
第五章、内存管理—虚拟内存
1、传统存储管理的特征、缺点
1、思维导图
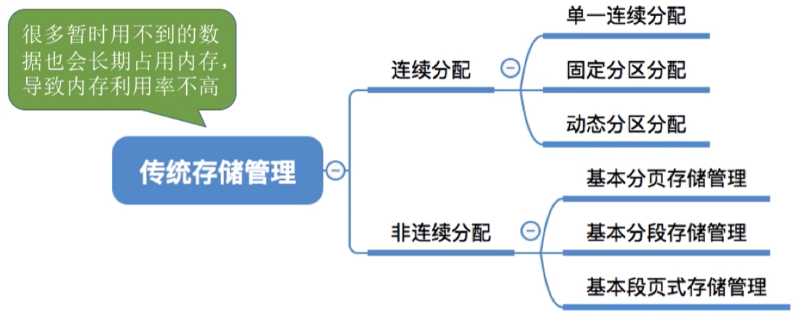
2、特征
1、一次性:作业必须一次性全部装入内存后才能开始运行
①作业很大,大作业无法运行
②多道程序并发度下降
2、驻留性:一旦被装入内存,就一直在内存。直到结束
2、局部性原理
1、时间局部性:如果执行了程序中的某条指令,那么不久后这条指令就会再次执行。(例如循环)
2、空间局部性:一旦程序访问了某个存储单元,在不就之后,其附近的存储单元也很有可能被访问
3、例子
3、虚拟内存的定义和特征
1、虚拟内存定义
1、程序装入内存中,可以将程序中很快用到的部分装入内存,暂时用不到的部分留在外存,可以让程序执行。
2、程序执行过程中,访问的信息不在内存,操作系统就会将该访问的信息调入内存,然后继续执行程序
3、如果内存空间不够,就会进行算法的置换,将暂时用不到的信息踢出内存,放入外存。
4、这个过程,让用户感觉内存很大,就是虚拟内存。
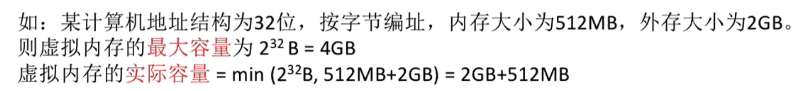
2、易混知识点
1、虚拟内存最大容量:计算机的地址结构(CPU寻址分为)确定
2、虚拟内存实际容量:min(内存和外存之和,CPU寻址范围)
3、例子
3、虚拟内存的三大特征
1、多次性:作业运行时允许被分成多次调入内存
2、对换性:作业运行时无需常驻内存,运行作业在运行的时候进行换入、换出
3、虚拟性:从逻辑上扩充内存的容量,让用户认为内存更大
4、如何实现虚拟内存
1、采用连续分配方式,不方便。建议
2、如思维导图
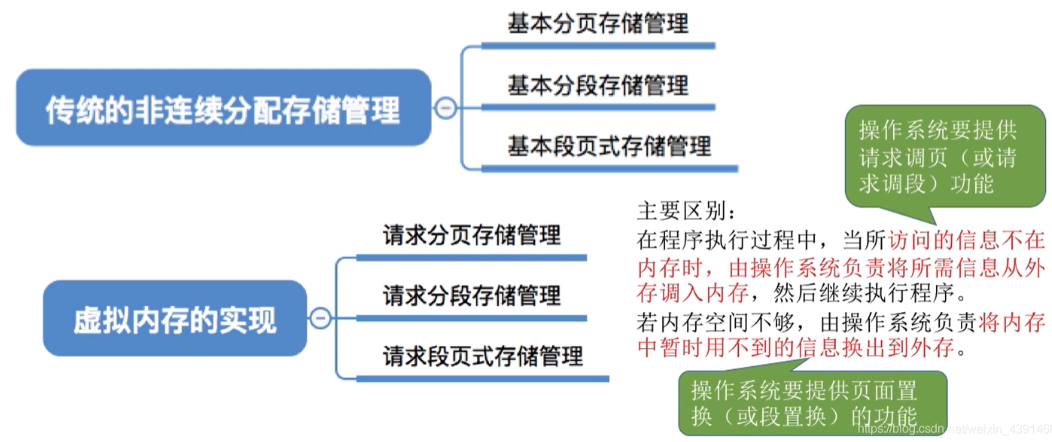
4、请求分页管理方式(请求页表、缺页中断机构、地址变换机构
1、知识总览
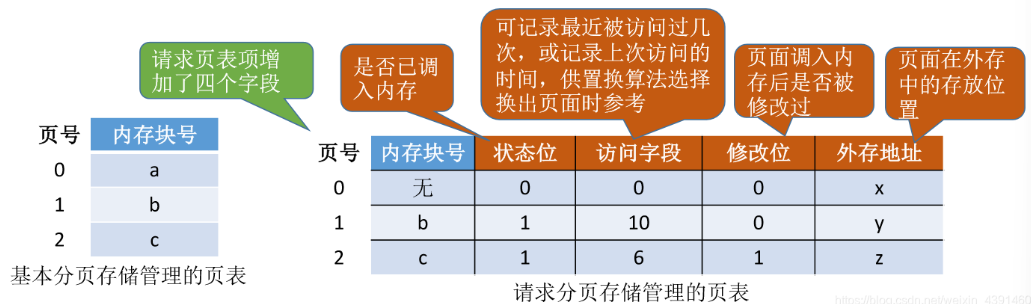
1、请求分页存储管理与基本分页存储管理的主要区别
2、操作系统要提供页面置换的功能,将暂时用不到的页面换出外存
3、操作系统要提供请求调页功能,将缺失页面从外存调入内存
2、页表机制——请求页表与基本页表的区别
1、请求页表机制,操作系统需要知道每个页面是否已经调入内存,没调入的话,页需要知道页面在外存中的位置
2、如果内存空间不够,就要置换算法。操作系统通过一些指标决定哪个页面需要被换走;有没有修改过,如果没有就不管,否则还要写入外存;
3、两种页表机制对比图
3、缺页中断机制
1、状态位=0,就是页面不在内存中
2、如果要访问一个逻辑地址=(页号,页内偏移量) =(0,1024)
3、但是没有找到,就产生缺页中断,然后该进程阻塞,就放入阻塞队列,等页面调出来了再放回就绪队列
4、如果内存中有空闲区,就给该进程分配一个新的空闲区,然后把缺页装入,然后修改页表化总相应的页表项。
5、如果内存中没有空闲区,就用算法进行替换页面(之前的页面如果修改过,就要写回内存)
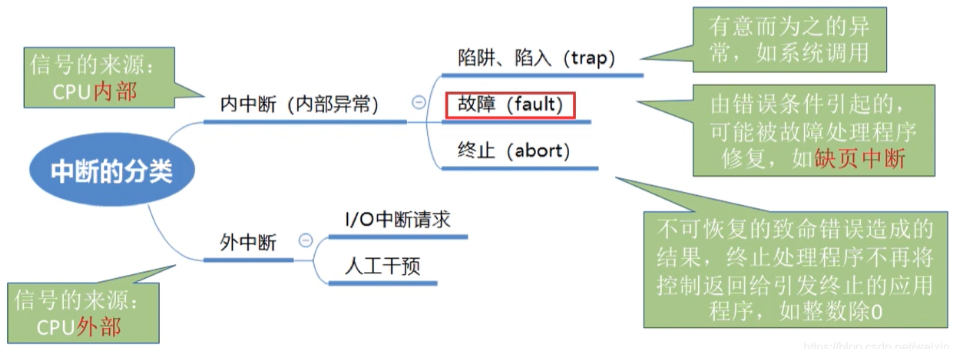
6、中断的分类(如图)
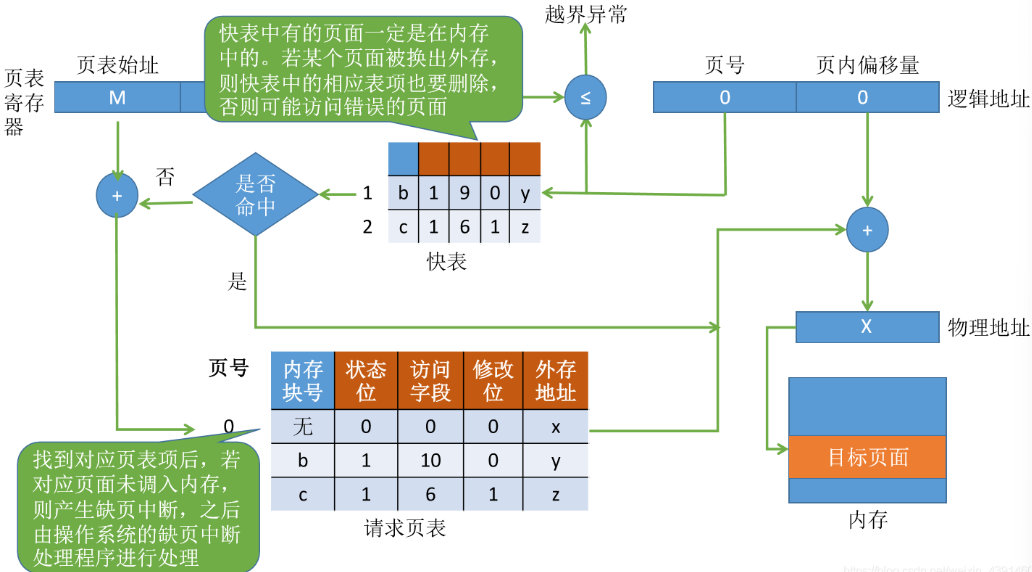
4、地址变换机构
1、新增步骤:请求调页(页表项的时候进行判断)
2、新增步骤:页面置换(看内存中有没有空闲项)
3、新增步骤:需要修改请求页表中新增的表项
4、整体逻辑图如下
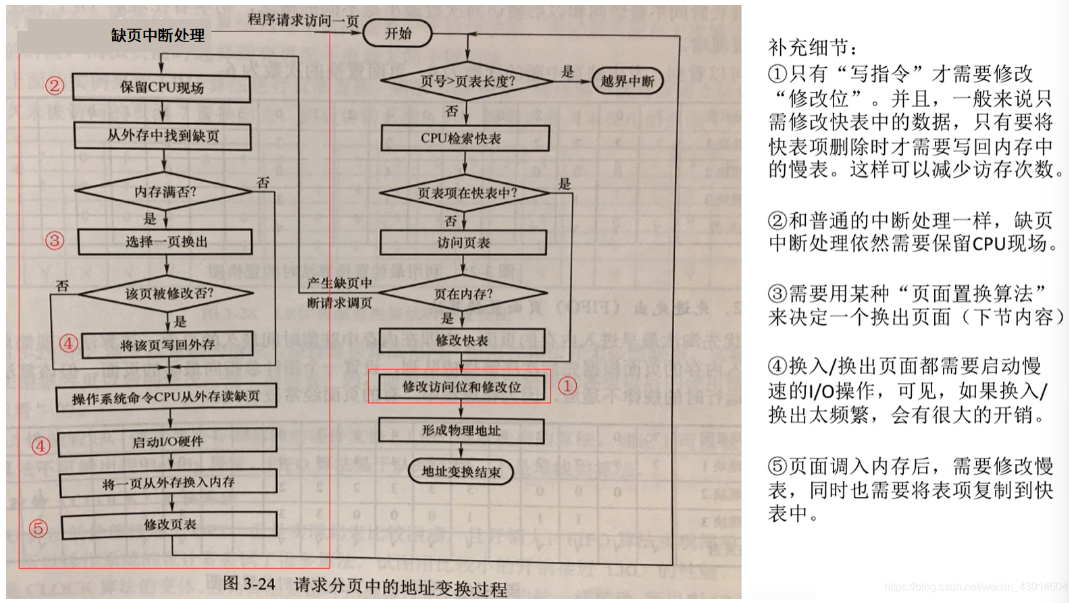
5、缺页中断处理逻辑图
5、页面置换算法
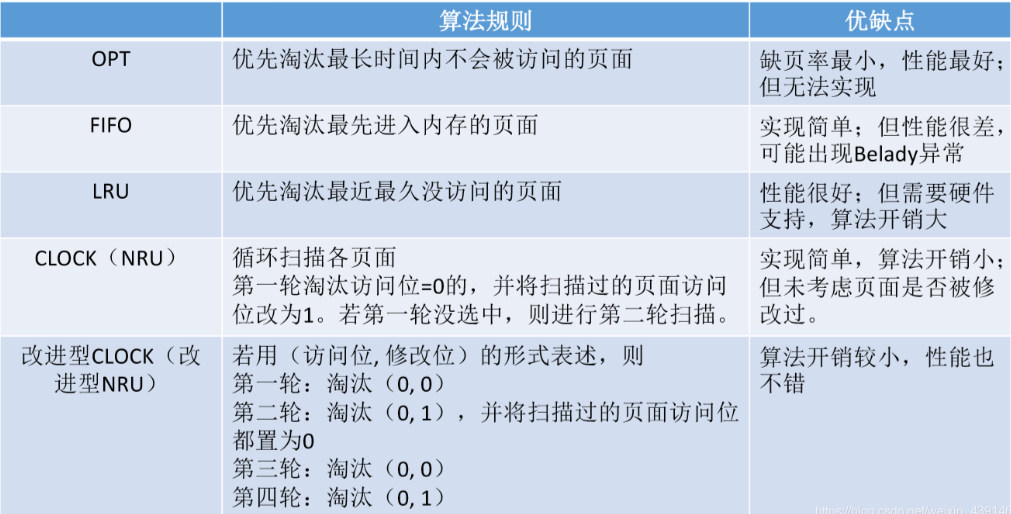
1、各种算法的优缺点
2、最佳置换算法(OPT)
1、思路
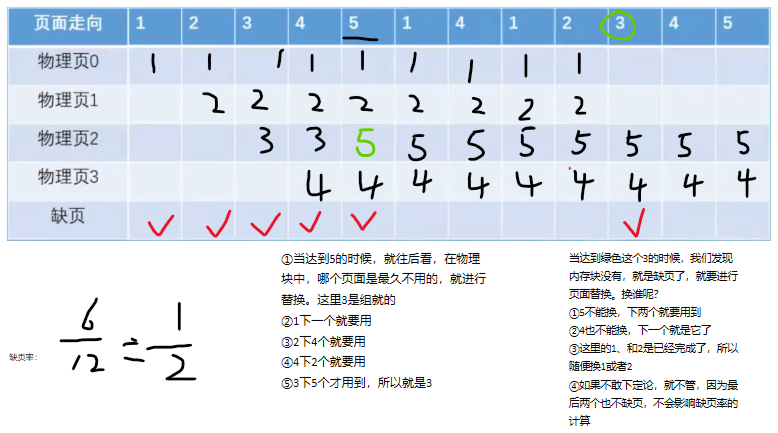
1、每次选择淘汰的页面,以后用不使用,或未来最长时间不再被访问的页面(往右边看)
2、最佳置换算法无法实现
2、例子
1、计算缺页率
3、先进先出置换算法(FIFO)
1、思路
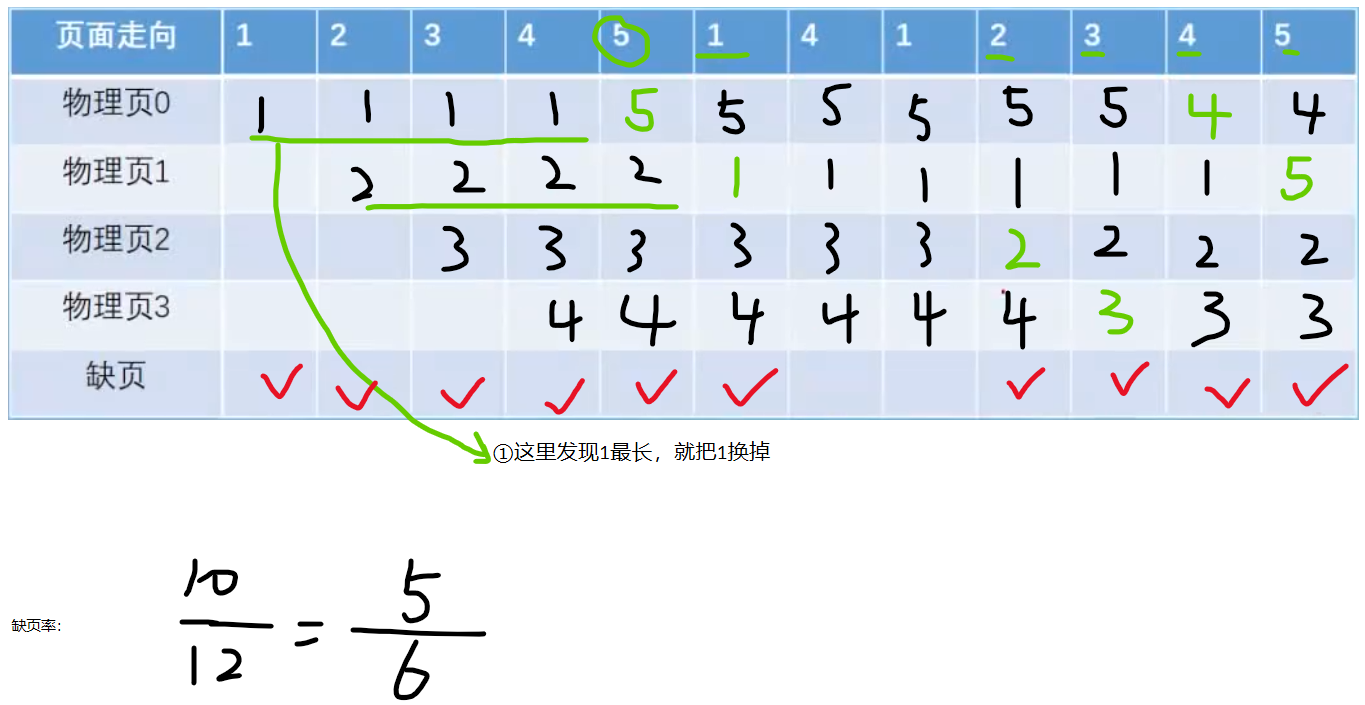
1、就是需要替换时,把最早进来的那个页面替换掉。
2、用队列实现
3、可以理解看左边,看哪个页面在物理块中待的最久,就换掉
2、缺点
1、会产生Belady异常
2、简单实现,容易除错,算法性能差
3、例子
1、计算缺页率
4、最近最久未使用置换算法(LRU)
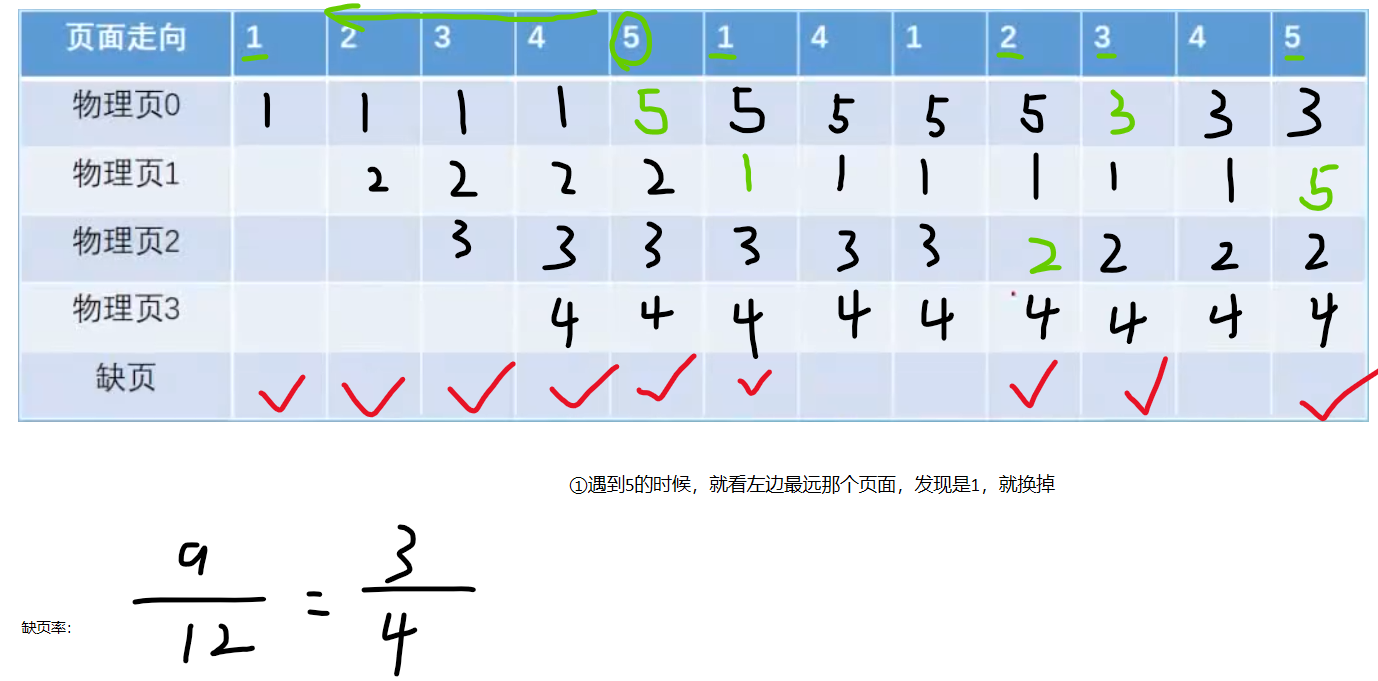
1、思路
1、就是要替换的页面的时候,换最近最久未使用的页面
2、例子
5、时钟置换算法——CLOCK
1、思想
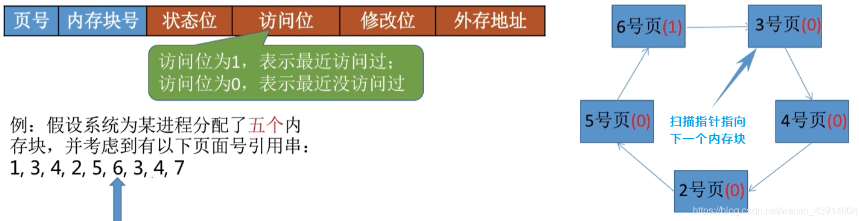
1、为每一个页面设置一个访问位
2、将内存中页面都通过链接指针链接成一个循环队列。当个页面被访问了,其访问位置置为1
3、当需要淘汰一个页面,只需检查页的访问位
①如果是0,就选择换出该页面
②如果是1,就将访问位置为0,暂时不换出,继续检查下一轮
4、如果第一轮扫描都是1,就将这些页面的访问位一次置为0,然后进行第二轮扫描
5、所以选择一个淘汰页面最多会经过两轮扫描。
6、图示